這是我花了300億opus5.5token之後的結論。
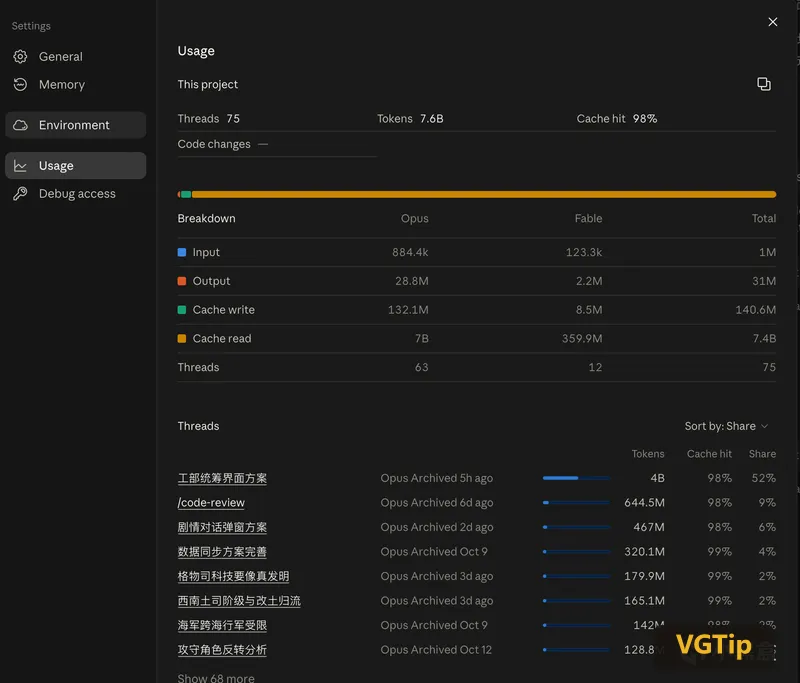
附圖:這是我一週的claudecode用量,codex可能會更多(畢竟tibo天天重置)
得出這個結論的原因在於:深刻感受到AI的侷限性,人才是駕馭ai的關鍵因素,人不行再強大的AI也救不了,但是AI並不會糾正使用者的錯誤,如果使用者沒有自己判斷能力和糾正的能力,AI只會在一次又一次詢問中越繞越遠,逐漸的離最開始的想要的目標越來越來,走向了一條永遠無法回頭的路,opus5.5和gpt6.1都無法倖免。
專業的程式設計師尚且如此,那麼沒有使用過AI的玩家配上低智商AI的結果只有一個:玩家的無能狂怒(因為AI只會順著你的話說下去),恰恰這個組合是AI推演遊戲裡最大的一部分群體。
所以回到主題:AI遊戲用那個2塊錢每100m的模型,經過3-4分鐘的思考,如何能推演出世界局勢的下一步走向,有的只是next token的強行擬合罷了。聊天的情況也是一樣,無法指望3s內AI就能根據整體盤面輸出理想的回答。說的就是你:大肥魚
舉個例子:明末力挽狂瀾遊戲盤面有20個地區,十幾支軍隊,30幾種財稅政策,150個人物,30幾種機制和數值,AI是根本無法再短時間就考慮完全,有的也是隻是next token的擬合。
結論就是:ai不可能三角
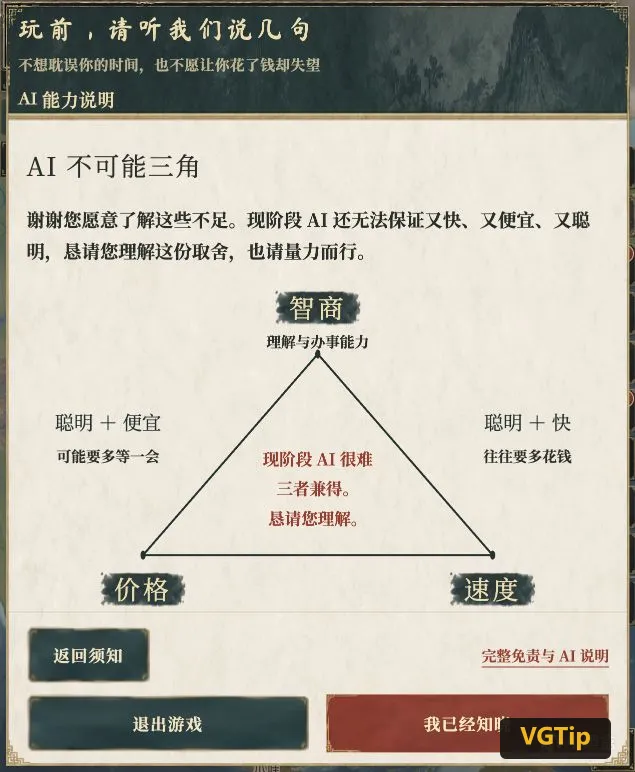
目前的LLM無法同時滿足人類對於價格,智商和速度的三者的要求。
你想要聰明,就必須要經過長時間思考或者高價模型 。
你想要回答快,就必須接受智商低和或者價格高
你想要價格低,就必須接受慢或者智商低
接下來會減少跟多的AI的戲份,增加更多的程式機制去達成遊戲裡的目標,這中間肯定會減少AI的自由度。
內閣六部的實裝,機制更加多樣化。
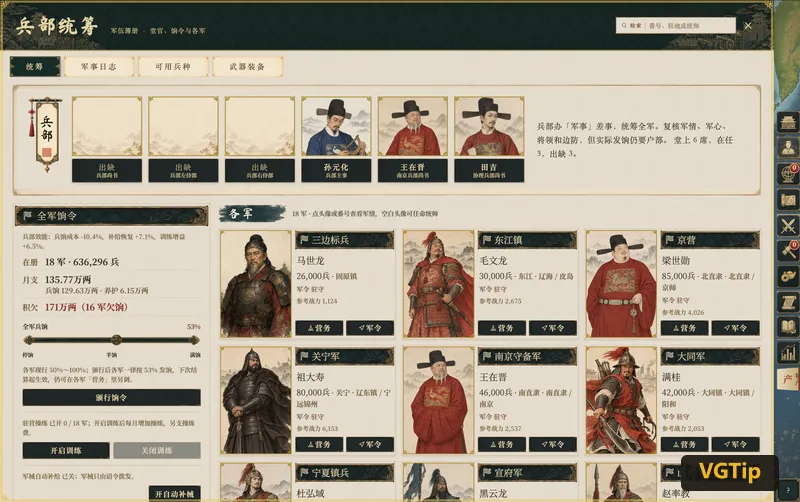
兵部 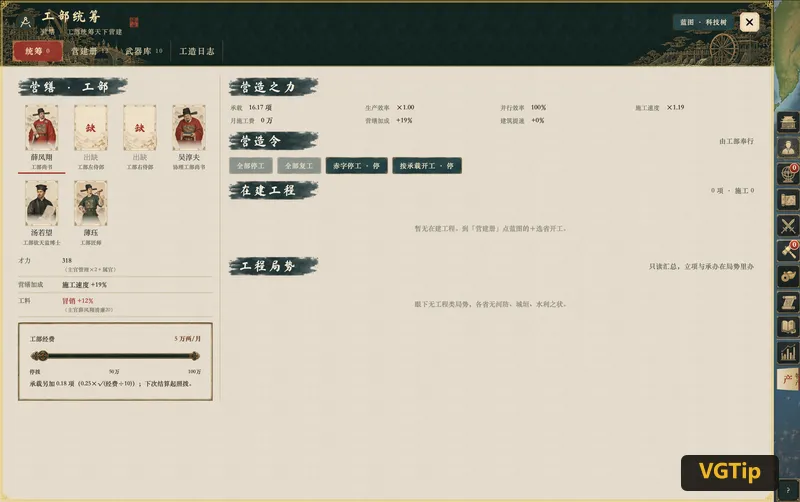
工部 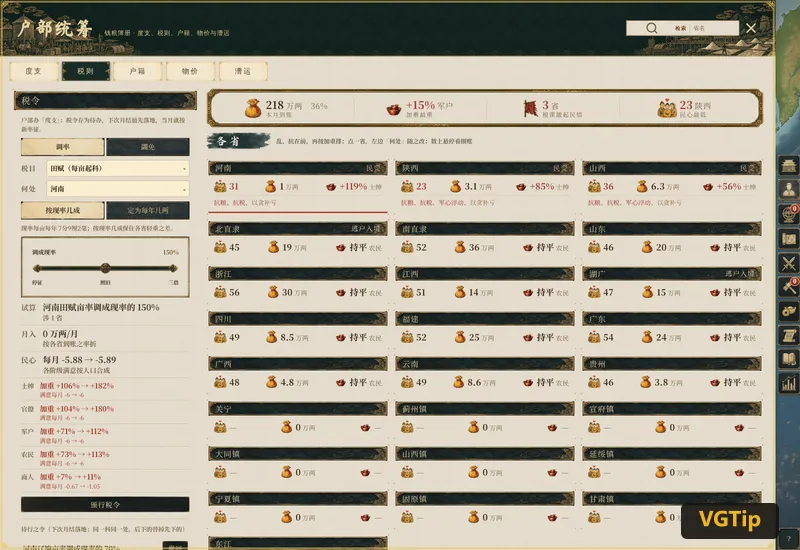
戶部稅制 京師紫禁城的實裝,玩法更加豐富。
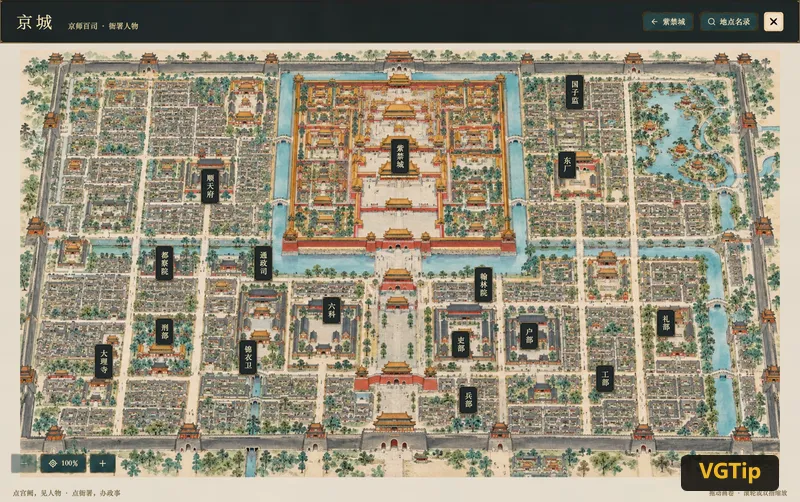
京師 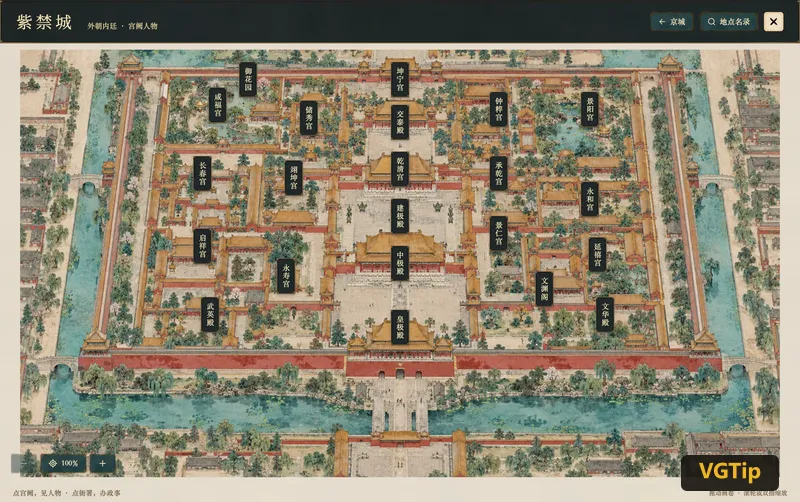
紫禁城 獨立於AI的經濟模擬,模擬更加正式。
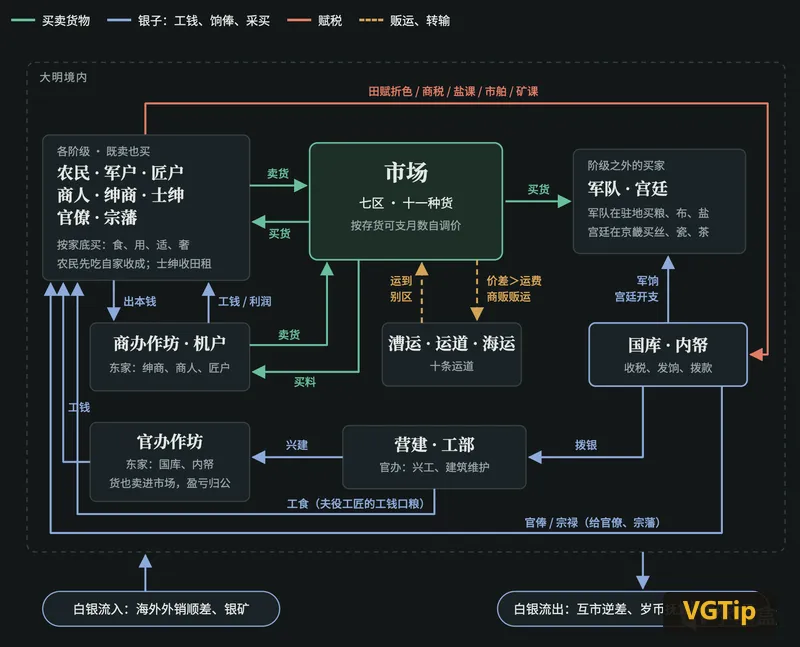
更多的明末劇情展現,更加真實。
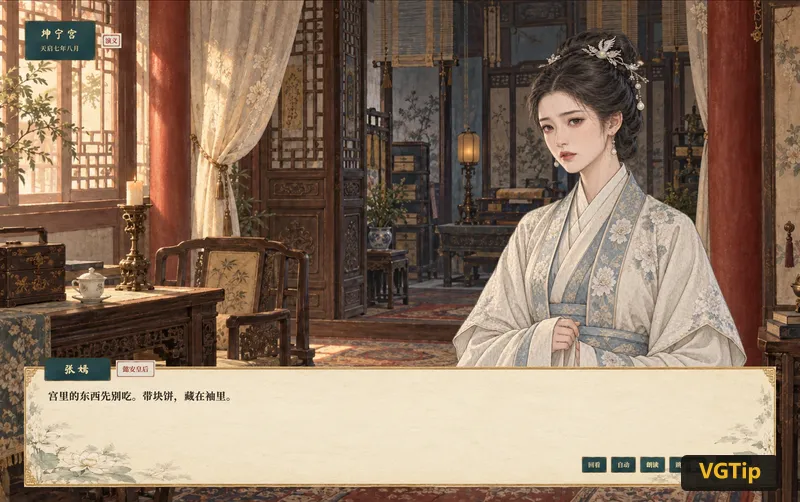
劇情
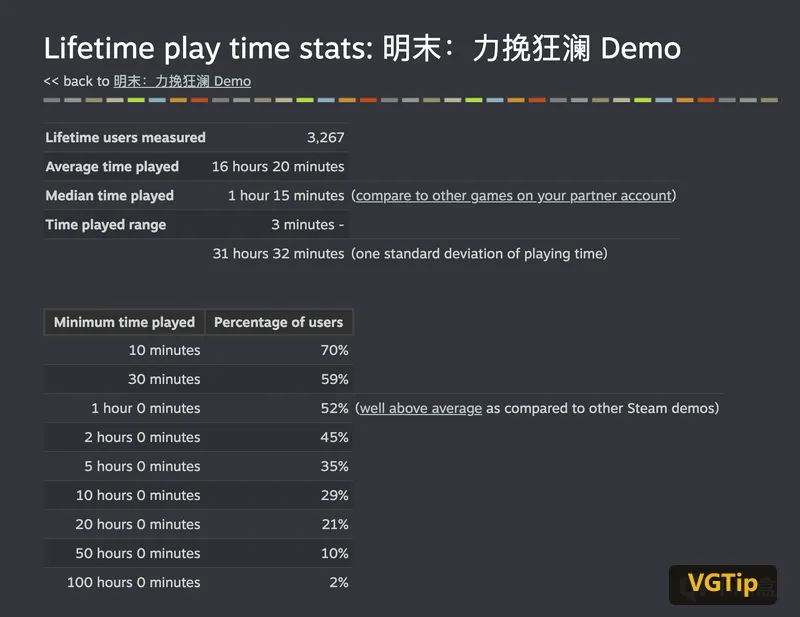
遊戲已經上架steamdemo3周,目前人均遊玩時長已經達到了恐怖的16hours,在接近50%的人開啟後關閉的情況下,剩下的人把時長活生生的拉到了16hours。
最後的最後:切記AI的不可能三角。