本文正文约 9200 字,预计阅读 35 分钟。
打开游戏,你把超分辨率设为 Quality,光追打开,帧生成设成 4×,游戏帧率便从几十涨到了两百多,转动视角也顺滑了不少。但玩上一会儿,还是能觉出一些不对劲:瞄准时鼠标没那么跟手,过弯时路边的护栏偶尔会扭一下,走进暗处,刚出现在视野里的反射要等一会儿才稳定下来。
这篇文章将围绕三个问题展开:同样显示 240 FPS,为什么手感差很多?输入像素降到四分之一,为何性能只提高一部分?光追的噪点已经消失,为什么反射仍会拖影?一起来吧,逐步拼出 SR、RT/PT、光线重建、FG/MFG 与低延迟调度这幅全景。
一、同样 240 FPS,一台跟手,一台迟缓?
先做一个理想化对照。甲配置每秒渲染 240 张完整场景,乙配置每秒渲染 60 张,再用 4× 帧生成补出其余画面。假设输出足够均匀,两者都能每隔约 4.17 ms 向显示系统交付一张图。沿着道路移动时,乙也能提供密集的运动位置;当你突然改变方向时,甲每隔约 4.17 ms 就有一次新的场景渲染机会,乙的完整场景间隔则约为 16.67 ms。
这里我们把经过完整场景渲染的画面叫作源帧,把送往显示系统的序列叫作呈现帧。源帧可以经过超分、去噪和后处理,生成画面则估计源帧之间的时刻。游戏模拟与输入采样可以采用各自的频率;源帧间隔描述的是新场景经过渲染交付的节奏。这样一来,都是240 FPS,我们就要再问一句:源帧有多少,生成画面有多少?
把 FPS 换成毫秒,差异会更直观。60 FPS 对应约 16.67 ms,120 FPS 对应 8.33 ms,240 FPS 对应 4.17 ms。下面公式里的 T_frame 为平均帧间隔,单位为毫秒。后面所有开销都用这笔账来算:每多花 2 ms,你希望换来多少细节、多少光照,或者多少中间画面?
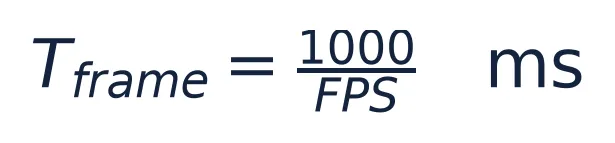
TechSpot 在 2025 年 1 月 28 日测试《心灵杀手 2》,使用 RTX 5090、4K 输出、DLSS Quality,并始终开启 Reflex,得到下面这组结果。呈现 FPS 与 PC latency 沿用评测数据,源帧率由呈现 FPS 除以倍率估算。
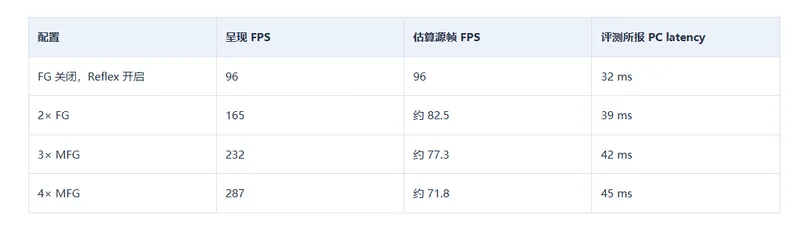
先看最后一行:屏幕得到的画面从 96 张增加到 287 张,源帧的生产速度则降到了约 71.8 FPS,对应约 13.9 ms 一张。生成阶段加入的工作改变了源帧预算,评测报告的 PC latency 也从 32 ms 增至 45 ms。在这套配置下,提高倍率确实增加了呈现密度,同时付出了源帧速度和 PC 内部延迟的代价。
鼠标移动之后,游戏需要把这次输入纳入状态更新,并将对应的渲染工作交给 GPU。若工作在队列里等了很久,即使执行本身很快,最终显示的仍是较早处理的状态。Reflex、Anti-Lag 和 XeLL 主要着手减少这段等待,让输入处理更靠近实际执行。下面的公式将沿途延迟加在一起。
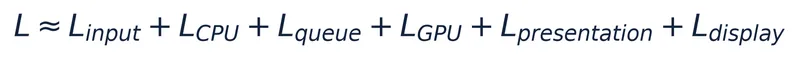
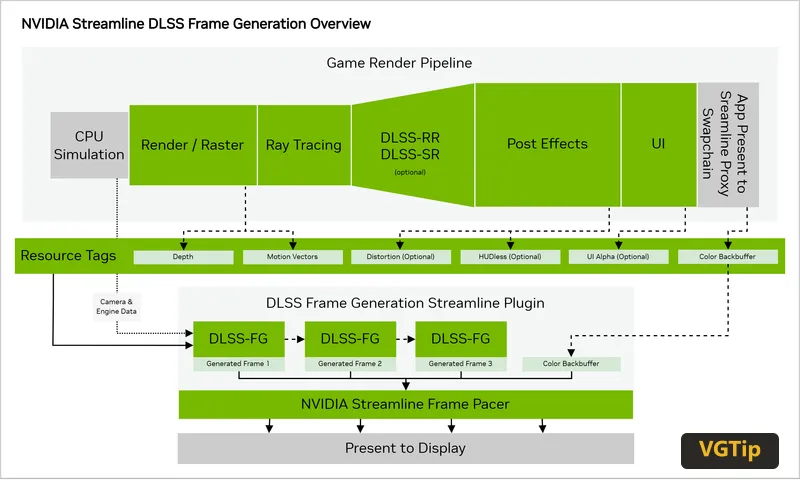
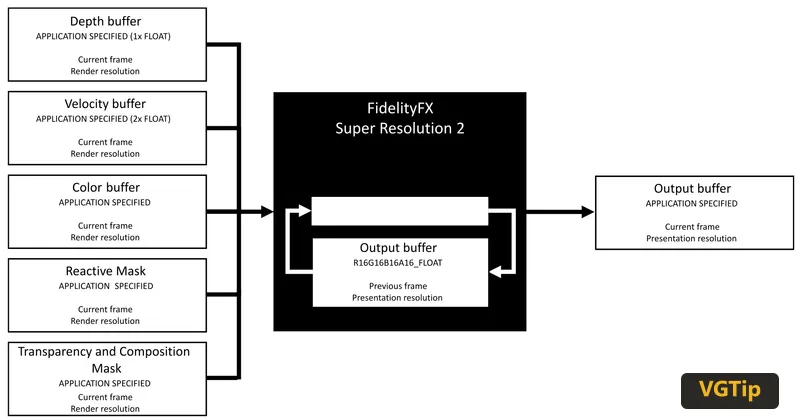
再看下面的集成图,可以先沿着颜色结果从渲染走到呈现。光线重建与超分会改变交给帧生成的图像,因此前级留下的模糊或错误也会进入生成输入。再看深度和运动矢量的支路,同一份资源被多个阶段使用,上游的描述误差就可能影响几处结果。图中的连接关系解释了一个重要现象:某个问题虽然在开启 FG 后更显眼,排查时仍可能需要回到 SR、光照或运动输入。
回到甲、乙两套 240 FPS 配置。判断它们时,可以先看完整场景多久交付一次,再看中间画面是否均匀、正确。接下来,我们先让完整场景更快地产生:把输入像素压到四分之一,看看能省下多少时间。
二、像素只剩四分之一,帧率却没翻四倍?
我们知道,4K 输出为 3840×2160,约 829 万像素;1080p 输入为 1920×1080,约 207 万像素。宽高各减半,像素数量就剩四分之一。若一帧里的所有工作都随输入像素同比缩减,性能确实可以接近四倍。但实际渲染还要处理几何、场景结构和部分后处理,超分本身也要组织完整的 4K 输出。我们从一个可手算的 GPU 预算开始。
假设原生渲染花 17 ms:其中 5 ms 属于这里暂按固定处理的工作,12 ms 随输入像素缩放。输入像素改为四分之一,这 12 ms 变成 3 ms,再支付 2 ms 的重建开销,合计就是 10 ms。源帧从约 58.8 FPS 提高到 100 FPS。最关键的是净省下的 7 ms:像素相关工作省了 9 ms,重建花掉 2 ms。
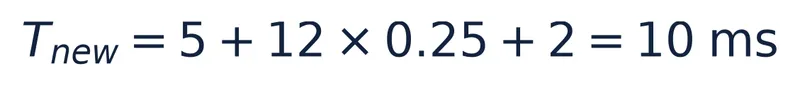
这 7 ms 可以直接换成更快的源帧,也可以部分投入光追。比如再花 4 ms 改善光照,总 GPU 时间就从 10 ms 回到 14 ms,约为 71.4 FPS;与原先的 17 ms 相比,保留了 3 ms 的速度收益。反过来,若某场景原本只有 2 ms 像素相关工作,另有 5 ms 固定开销,同样操作后就是 5+0.5+2=7.5 ms,高于原先的 7 ms。
再把 CPU 加回来。假设 CPU 每帧需要 12 ms,GPU 已经从 17 ms 降到 10 ms,连续产出就会主要受 CPU 节奏约束,源帧大致接近 83.3 FPS。此时进一步降低输入分辨率,GPU 的空余可能继续增加,源帧提升则逐渐趋缓。
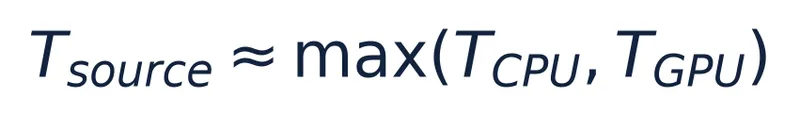
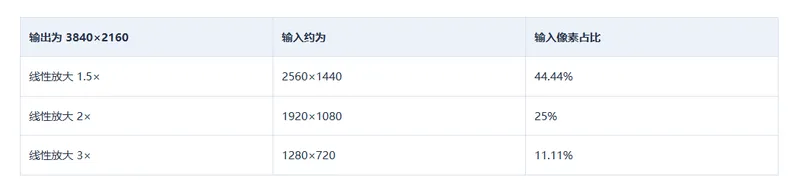
实际 GPU 阶段还可能重叠执行。重建与其他工作并行时,最终新增多少帧时,要看它延后了哪一项关键工作。选择超分档位时,可以先按下表把输入规模算清楚:1.5×、2×、3× 指宽高上的线性放大,像素占比随宽高一起变化。
计算性能差距之后,另一个疑问才真正出现:只采了四分之一的像素,细节从哪里来?先让相机停住,盯着远处一根很细的电线。如果每帧都在相同位置采样,错过的细线就可能一直被错过。Jitter(抖动) 会轻微改变下一帧的亚像素采样位置,让原先空缺的观察有机会被补上。只要这些结果确实属于同一根电线,重建器就能把多次观察积累起来,逐渐建立稳定的细轮廓。
相机开始移动后,积累过程多了一道对齐任务:电线在屏幕上的位置变了,上一帧的颜色应当搬到哪里?运动矢量为重投影提供这个对应关系,历史通过校验后才参与当前重建。
现在让人物从电线前面跑过。人物离开后,背景突然露出;此前该位置保存的颜色属于人物,当前需要恢复背景。重建器需要依靠深度、运动、亮度变化等线索拒绝这段历史,并用当前稀疏观察重新开始。你看到的轮廓残留、突然闪动和逐渐稳定,就对应这次判断与重新积累的过程。
下面用简化混合式描述它。Hₜ(x) 为当前重建结果,Cₜ↑(x) 为当前低分辨率观察的重建,Hₜ₋₁ 为历史;𝒲 根据运动信息 vₜ 重投影,wₜ(x) 决定历史贡献。历史权重较大,静态细线更容易稳定,过时颜色也会保留更久;更积极地采用当前观察,新露出区域跟进更快,采样不足处会更容易闪动。
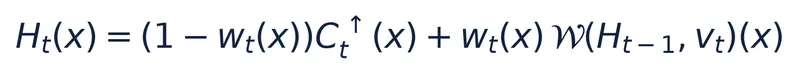
把观察对象换成《地平线:西之绝境》的瀑布,水流内部一直在变化,半透明水雾叠在岩壁前面,用一组表面运动去解释整个像素会很吃力。下面是 AMD 发布的同场景对照,上图采用 FSR 3.1,下图采用 ML FSR Upscaling。
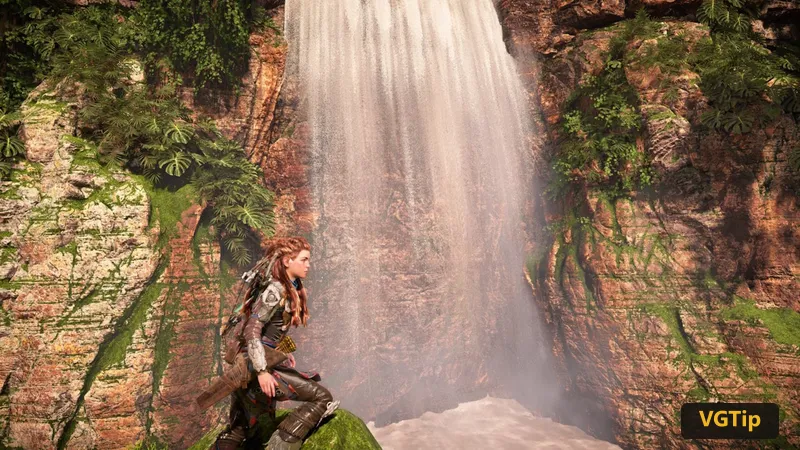
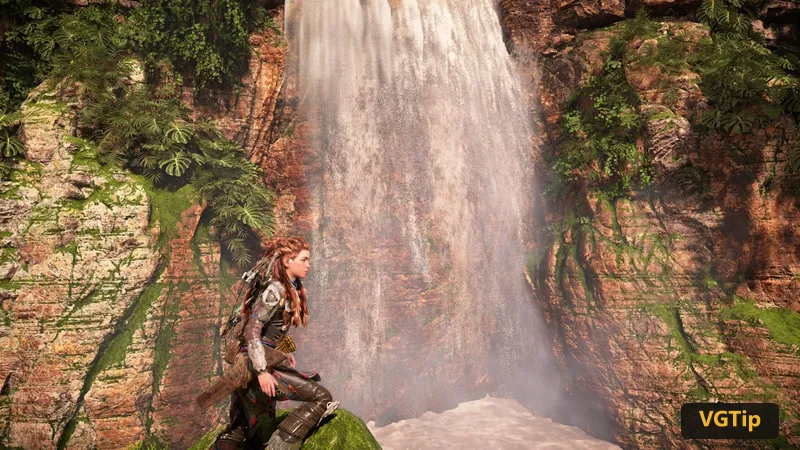
图 3–4|AMD 原图。对照瀑布中上部的水流结构,人物与两侧岩壁可作为位置参照。
上图的瀑布呈现较均匀的竖向条纹,中段的水雾像一层稀薄白纱;下图能看见更明显的水流分叉和宽窄变化,亮水束之间也保留了暗缝。两侧岩壁与人物的大轮廓相近,主要差异集中在持续变化的水流内部。
玻璃和镜面反射也有类似困难。一层玻璃可能同时承载前景和透射背景,单个运动矢量对这种混合关系的表达有限。引擎提供的遮罩可以提示算法对相应区域加快更新;输入信号的组织方式因此会影响同一算法在不同游戏里的效果。
TechSpot 在 2026 年 1 月 23 日用《赛博朋克 2077》4K Ultra RT、Quality 档比较 DLSS 4.0 Preset K 与 4.5 Preset M:RTX 5070 Ti 的帧率约下降 5%,RTX 3090 约下降 19%。换成单帧时间,分别约增加 5.3% 和 23.5%。
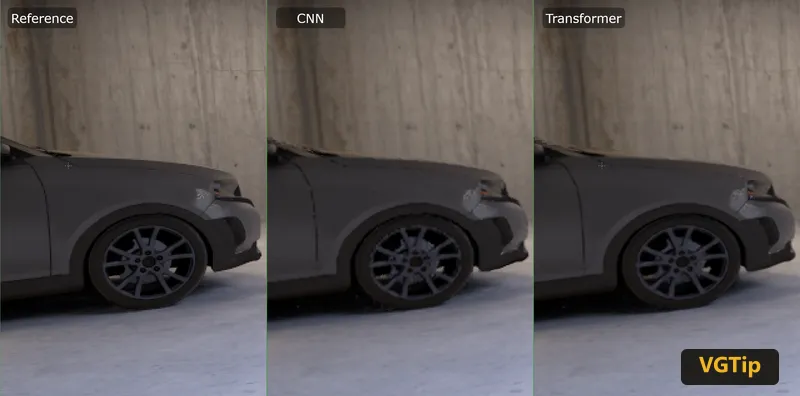
图 5|NVIDIA 研究页原图。
这张图可以看车前轮的细辐条:中间结果的斜线边缘呈现更明显的断续和锯齿,右侧的轮廓更连贯,形态也更接近左侧参考。
回到原先的 17 ms 场景。超分帮我们净省了 7 ms,但画质还依赖历史。现在把一部分时间交给光追:它会为像素收集另一类信息——光从哪里来,经过哪些表面,怎样才能让反射、阴影和间接光照更贴合场景。
三、光追已经去掉噪点,为什么反射仍会拖影?
走进《赛博朋克 2077》的室内,先看一块映着身后物体的玻璃。要算出这块玻璃的颜色,渲染器需要知道反射方向会碰到什么;那个物体即使落在视野外,仍然会影响当前像素。光线追踪为这种查询提供了场景信息。路径追踪把查询继续沿散射路径展开,估计光经过其他表面后送来的贡献,因此也能将间接光照纳入同一套光传输计算。
下面的渲染方程展示,一个表面向眼睛送出的光,来自自发光和各个入射方向的反射贡献。Lₒ 为出射辐射亮度,Lₑ 为自发光,Lᵢ 为入射光,fᵣ 描述材质怎样分配反射,余弦项计入方向与表面法线的关系。积分表达的是整个反射半球。我们只需抓住一件事:为了知道这个像素有多亮,渲染器需要了解其他方向送来了多少光。
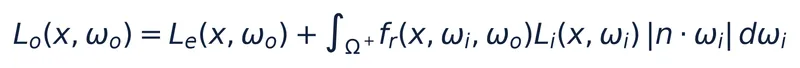
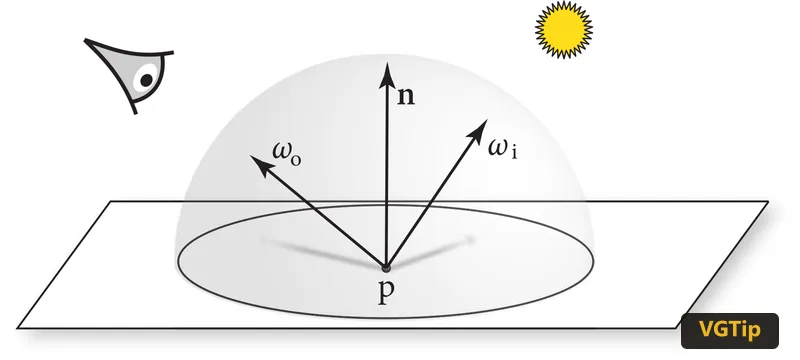
图 6|图中的入射方向对应需要估计的光,出射方向对应观察方向。
游戏每帧只有几毫秒可用,渲染器会采样部分方向,用有限路径估计整个积分。若某个方向恰好碰到强光,贡献很大;另一个方向落在暗处,贡献很小。少量随机观察就会形成亮暗起伏,也就是噪声。下面的蒙特卡洛估计用 N 个样本及其概率密度 p(xᵢ) 来计算结果。在常见的独立采样条件下,标准误差按样本数平方根下降:想让噪声幅度减半,通常需要约四倍样本。
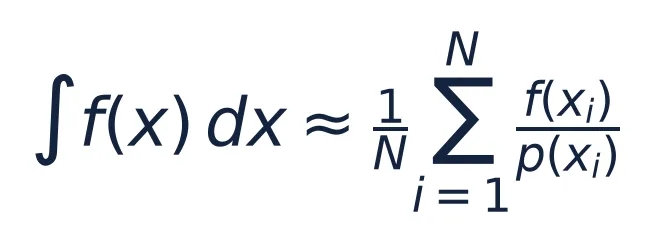
这可以与前面的超分预算接起来。假设增加光追采样能占用的额外时间只有 4 ms,直接把所有样本翻四倍,很容易超过预算。首先可以改善查询的去向:同样发出一条射线,找到重要光照贡献比落在几乎全黑的方向更有价值。采样策略由此成为提升效率的入口。
例如,房间里的主要照明来自一盏很小的强光。纯粹随机挑方向,可能花了不少查询仍错过它;直接采样光源,就能更有针对性地估计这部分贡献。如果邻近像素或上一帧已经找到有价值的光源候选,ReSTIR 还可以通过时空重采样复用它们。
间接光的重复查询则引出另一种办法。假设很多路径都会继续询问某一区域能送来多少反弹光,把这个估计保存到辐射缓存,就能减少后续重复计算。缓存的估计需要随场景变化更新;灯光突然移动时,旧值退出得有多快就会影响动态表现。这里已经出现了与时域超分类似的取舍:复用带来效率,同时需要及时识别过时信息。
射线查询本身也有开销。为了快速找到可能命中的物体,BVH 用层次包围区域排除大片空间,查询只在有希望命中的区域继续深入。对象内部的结构通常放在 BLAS,实例及其变换由 TLAS 组织。场景中的人物开始蒙皮变形后,相关结构也需要更新,所以减少发射射线的像素,仍会留下场景组织这笔开销。
先把性能问题留在这条查询链上,再来看重建本身会怎样改变画面。下面《心灵杀手 2》金属门的 CNN 与 Transformer RR 对照,观察对象是同一块粗糙反射表面的细节。
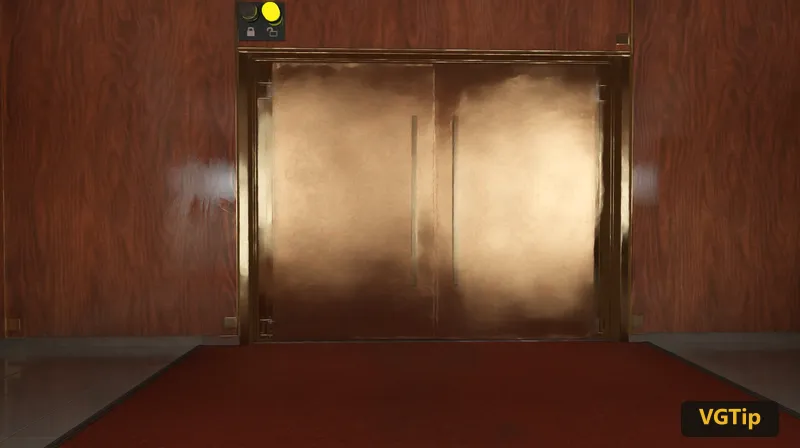
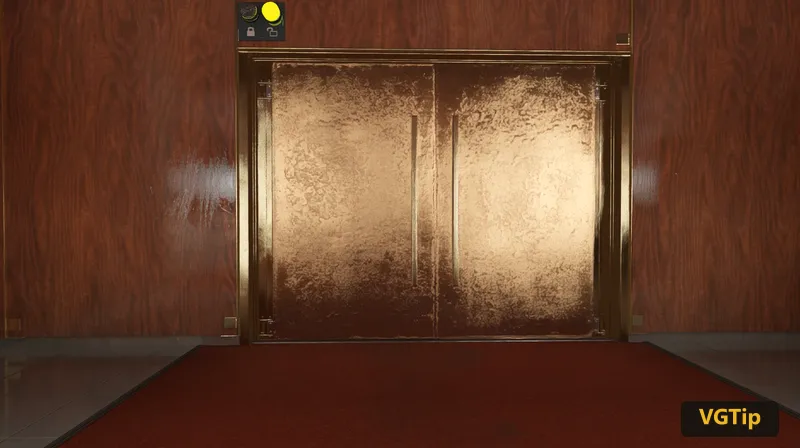
图 7–8|NVIDIA 发布的同场景模型对照。
上图的金属门仍有完整的亮暗轮廓,但高光覆盖的门板被处理成较平滑的色块;下图在相同位置出现了密集的斑驳结构,中央两根门把手附近也更容易辨认局部变化。两张图都能给出干净的门,高频细节的处理明显不同。
TechSpot 在 2025 年 2 月 8 日的 RR 分析中,保持 SR 模型一致,比较旧 CNN 与新 Transformer RR。它报告新模型改善了多种表面的纹理和运动稳定性,同时观察到停住后一两秒细节逐步收敛,光照改变仍需数帧响应。
再看《赛博朋克 2077》的含噪输入与重建结果,上面的问题会变得更直观。
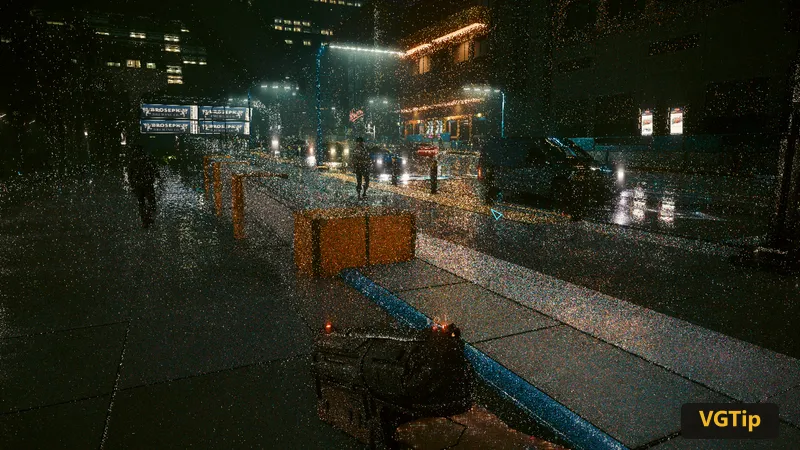
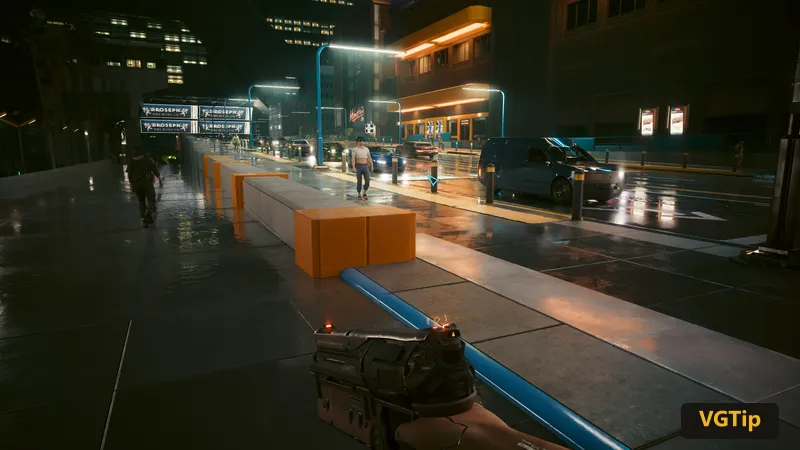
图 9–10|NVIDIA 发布的含噪输入与重建结果。
输入中,橙色路障的表面散布着强烈的亮暗颗粒,右侧路面反射也被噪点切碎;重建后,路障恢复为连续色面,车灯下的反射呈现出明确的亮带。这组变化展示了稀疏光照经过整理后如何形成可阅读的表面。
于是,本章的问题还剩时间这一半。反射拖影的常见原因包括旧历史退出缓慢、重投影对应有误,以及相关缓存更新滞后。相机停住时,历史积累容易压低噪声;突然转向后,新露出区域只有少量当前样本,算法就要重新取舍。若继续倚重旧历史,过时光照会跟着留下;若更快交给当前观察,采样稀疏处又可能闪动。验证这一点,可以让遮挡物移开,记录反射从露出到稳定的过程,上面的静态图承担的是展示噪声与细节两类结果。
RR 与 SR 的处理顺序也会影响信息保留。若低分辨率去噪先抹掉了细小反射,后续超分接到的就已经是平滑信号。联合重建尝试让几个任务共享更多原始信息,DLSS RR 采用这条路线;AMD Ray Regeneration 则提供独立去噪的接口路径,便于分别组织各阶段。下面两张图把这个差别画在了信号经过的位置上。
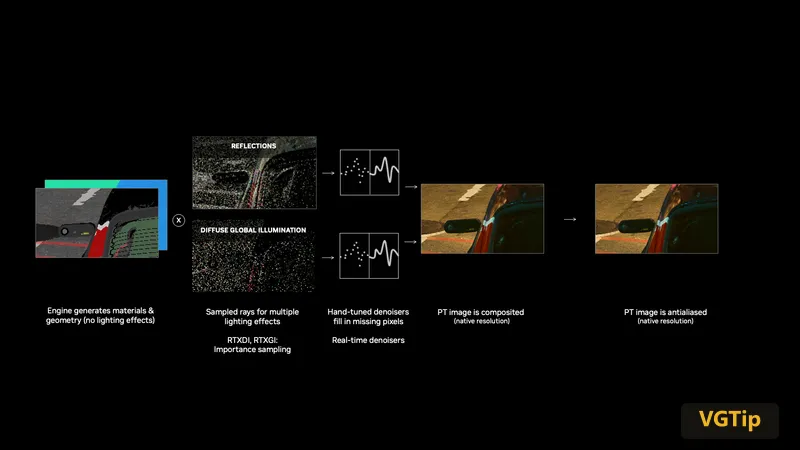
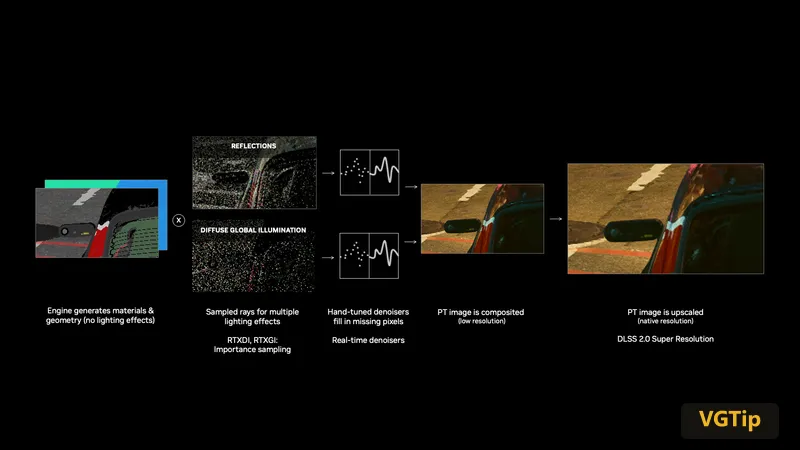
图 11–12|分立流程与联合重建示意。
成本如何?TechSpot 在 2026 年 8 月 26 日比较 RR Preset D 与 F,五款测试游戏的大多数结果相差约 1 FPS 以内,并观察到部分噪声与细节变化。把它与第二章的 SR 测量放在一起,就能理解:同一代产品名称下,SR 与 RR 的模型更新可以带来不同的开销变化。
如果想判断这笔光照预算换来了什么,《黑神话:悟空》的水池更适合直接对照。
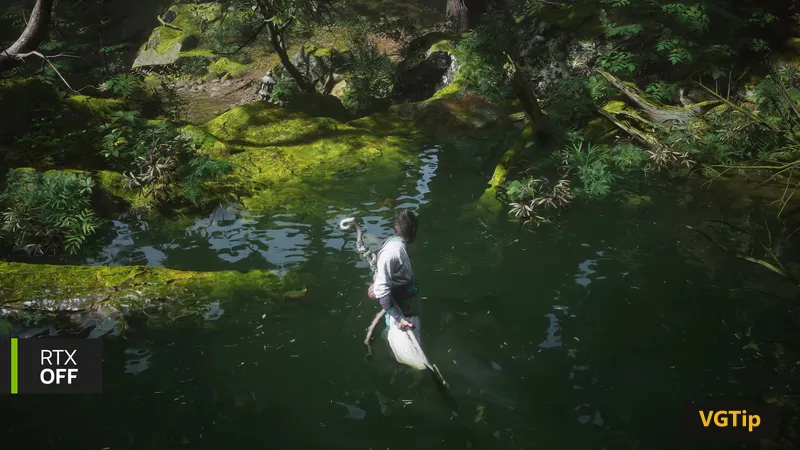
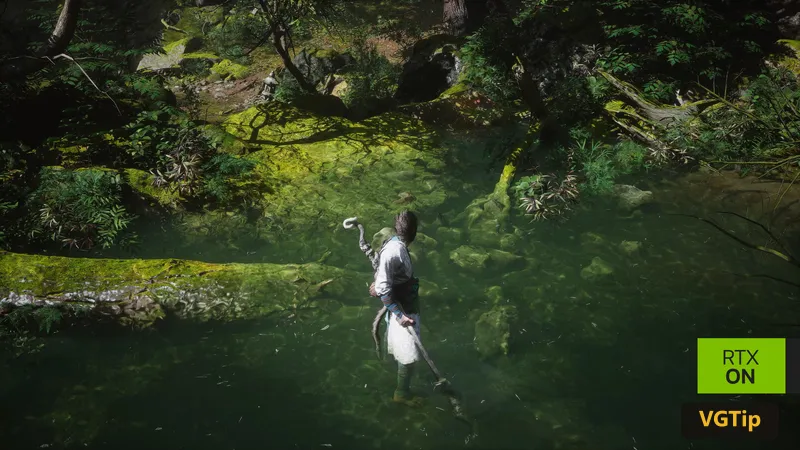
图 13–14|同场景开关对照,来自 NVIDIA。
关闭时,池面有明显的大片浅蓝反射,池底的亮暗较平缓;开启后,浅水区域能辨认出更密的石块形状和随水面折射扭曲的亮纹。这些亮纹对应光经起伏水面折射后在池底重新分布的焦散。比较的意义因此落在可指认的光照关系上:新增计算让水下受光具有更丰富的空间结构。该开关同时改变反射等效果,图中整片水面的差异包含多项光照变化。
到这里,一张源帧已经经过稀疏光照、历史重建与超分。它可能很干净,也可能留着反射拖影或边缘游动。接下来,帧生成会把这些结果当作输入,估计更多中间时刻。于是第三个问题接上了第一个:我们希望把画面补得更密,同时保证补进去的内容更值得显示。
四、补出来的画面,在护栏和 HUD 上露馅?
想象《F1 25》里一次持续过弯:车身向一侧移动,近处护栏迅速掠过,远处建筑移动较慢,HUD 固定在屏幕上。如果只把前后两张源帧叠起来,车会出现重影,背景也会错位。FG 需要先建立对应关系,再估计中间时刻各个位置应当出现什么。下面公式中,Iₜ 和 Iₜ₊₁ 为相邻输入,α 为相对时间,v 与 d 提供运动和深度,F 表示生成过程。
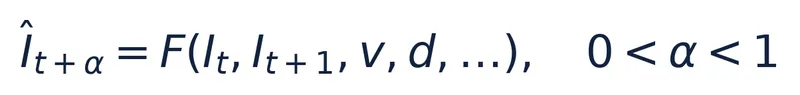
车身移开后,原先挡住的背景只在部分输入中出现。此时即使已经知道车身怎样运动,仍要判断空出来的位置应当由谁补上。反射和阴影也会带来独立于表面几何的变化,光流从颜色图像中估计表观运动,帮助算法建立这些对应。遮挡频繁变化的细护栏因此很有价值:它反复要求算法在前景与背景之间切换可见关系,很容易暴露估计误差。
源帧间隔越长,估计跨度越大。30 FPS 的相邻源帧相隔约 33.33 ms,60 FPS 相隔约 16.67 ms;相同速度下,前者跨过的位移更大,期间显露和遮住的背景也更多。提高倍率是在这段跨度内增加估计时刻。因此,提升源帧速度常常能同时改善交互和生成条件。
多帧生成会复用一部分输入特征,再为多个中间时刻进行处理。4× 对应每个源帧周期四张呈现画面,其中三张为生成画面;6× 对应五张生成画面。模型计算、缓冲与呈现安排共同决定实际成本。下图展示了共享计算与各时刻处理的关系。计算输出时,应当用开启生成后的源帧率乘倍率:若原先 60 FPS,开启后源帧降到 54 FPS,4× 输出约为 216 FPS。
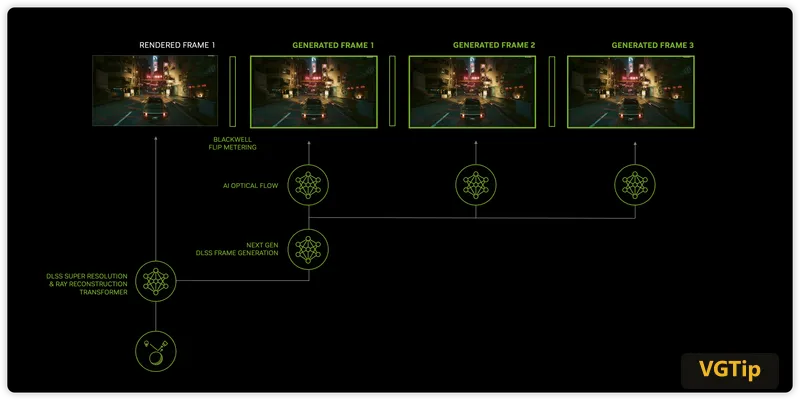
图 15|NVIDIA 多帧生成模型示意。
HUD 提供了另一类线索。速度表固定在屏幕坐标,背后的场景持续运动,二者在同一位置叠加。集成时可以把 UI 与场景分离,再单独合成,这能给算法更明确的层次关系。至于数字什么时候变化,还取决于 UI 状态的更新频率:一张清楚的 UI 纹理若按源帧更新,其中的动画也会沿这个节奏前进。
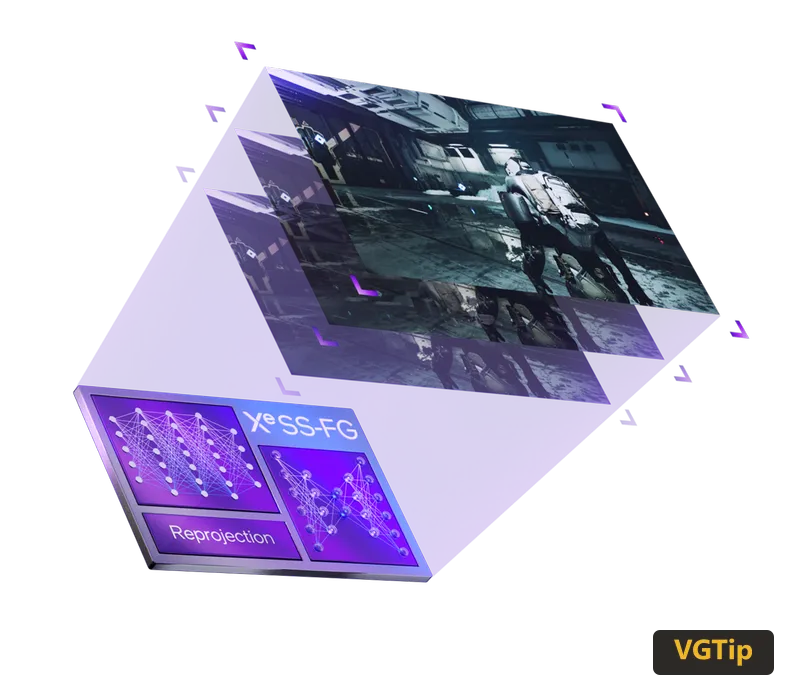
图 16|XeSS 重投影层示意。
具体会错成什么样,可以看 GamersNexus 对《最终幻想 XVI》的逐帧检查。左边为第一张源帧,右边为序列中间的生成帧。该组采用约 30 FPS 源帧与 4× MFG,属于较大运动跨度的观察条件。
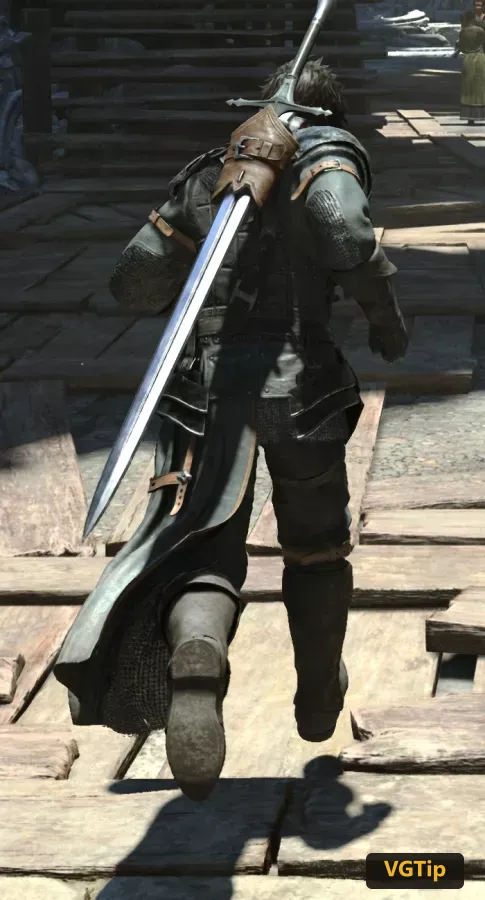
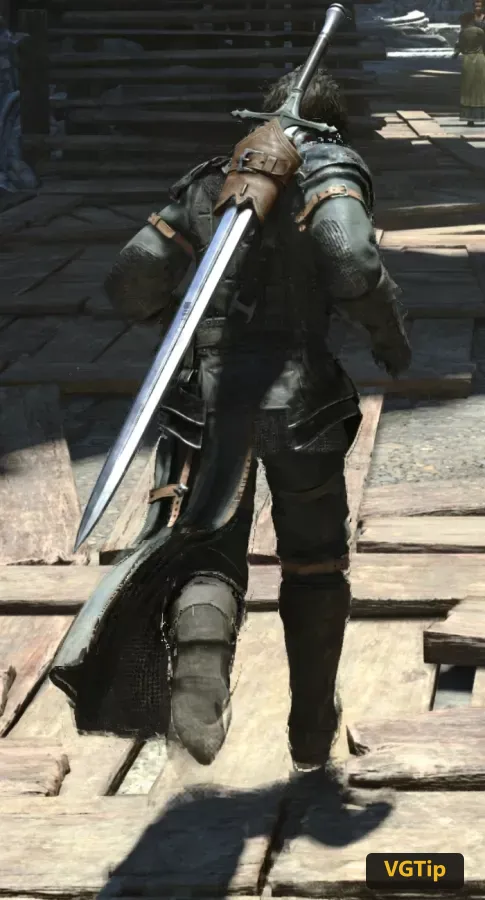
图 17–18|GamersNexus 已发布的裁切图。
源帧的靴底轮廓清楚,衣摆与腿之间有明确空隙;中间生成帧的脚部出现半透明叠影,衣摆边缘与后方木板交错。这正是不同运动区域在中间时刻发生混合的可见结果。
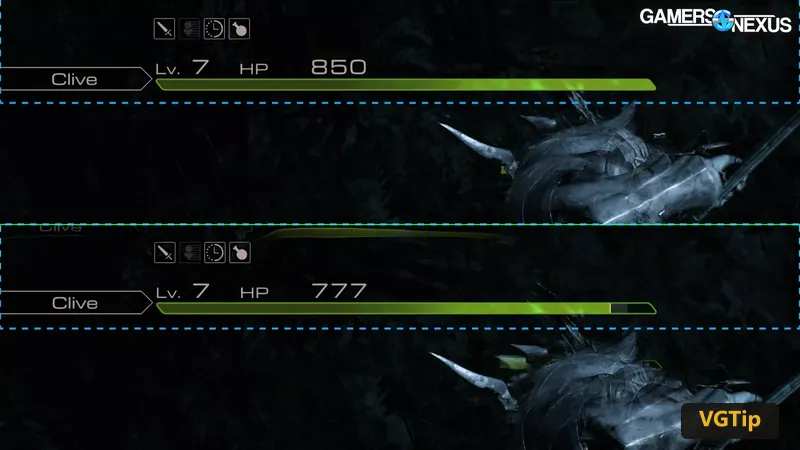
图 19|同一评测发布的 UI 局部图。
再看血条:画面中部的主血条仍在原位,上方又出现了一段弯曲的绿色副本。它展示了场景运动与固定界面叠加时的生成错误,让 UI 分离与合成的意义变得具体。
平均 200 FPS 意味着平均间隔 5 ms;若显示间隔在 2 ms 和 8 ms 之间交替,平均值同样是 5 ms,运动的时间分布就会呈现明显起伏。高倍率带来了更多待呈现画面,交换链、同步方式、限帧与显示扫描需要将它们安排均匀。
现在再回到开头的 240 FPS。这些现象的常见原因包括源帧产出偏慢、队列等待、上游重建错误、生成阶段的运动估计,以及呈现间隔波动,它们可能叠加。比如,GPU 长帧会同时拖慢操作反馈和画面交付;护栏的抖动也可能先出现在 SR,再被生成阶段带入更多画面。可以先关闭 FG,沿同一路线检查源帧中的问题是否仍在,再结合帧时、延迟与呈现记录缩小范围。
五、给你一台电脑,怎样把它们变成设置?
从一条你熟悉的路线开始:室外缓慢横移,走进有反射的室内,再快速转向,最后停住。先关闭 FG,固定输出分辨率、光照档位与超分模式,记录源帧时间;有合适测量工具时同时记录延迟。这样会得到一条能反复对照的起点。比如目标源帧为 90 FPS,对应约 11.11 ms。
若源帧需要 17 ms,先尝试降低输入尺寸,观察它是否明显缩短。大幅缩短,说明可缩放的 GPU 工作占了较大比例;变化很小,再检查 CPU、几何、结构更新和固定处理。若实际源帧降到了 10 ms,就沿横移与转向过程检查细线、粒子和新露出背景。如果质量达标,这个配置已达到 90 FPS 目标,还剩约 1.11 ms 余量;若只有 GPU 降到 10 ms、CPU 仍需 12 ms,就先处理 CPU 一侧的限制。
接着决定光照预算。把同一室内的光追关闭与开启结果对照,指出你实际获得的变化:反射内容、间接光层次、阴影关系或水底焦散。再检查新增成本和运动恢复。如果某项效果在主要游玩视角里贡献很小,而开启后源帧明显超预算,这笔时间可以转给更高输入或更短响应。
源帧质量与速度确定后,再开启 FG 并逐级比较倍率。每次切换都重新记录源帧时间,因为生成工作也会争用预算。若护栏出现新的变形,回到关闭 FG 的同一路段确认它从哪一阶段开始;若手感与连续性同时变差,先查看是否出现长帧或更深的等待。第一章的《心灵杀手 2》数据已经展示,倍率提高时源帧和延迟可能一起变化。
这套顺序也能用于理解新的外观生成阶段。DLSS 5 的 3D-Guided Neural Rendering 以渲染结果、运动与时间状态等为条件,结合学习到的外观先验处理材质和光照外观。《NBA 2K27》的皮肤、衣料与局部照明是可见案例。
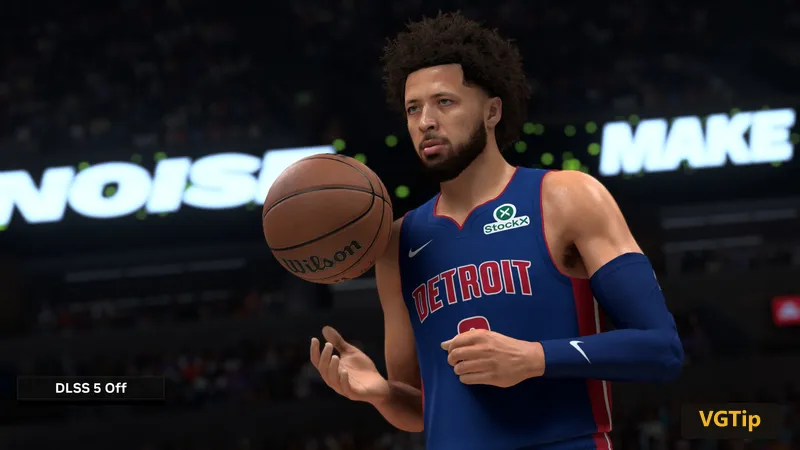
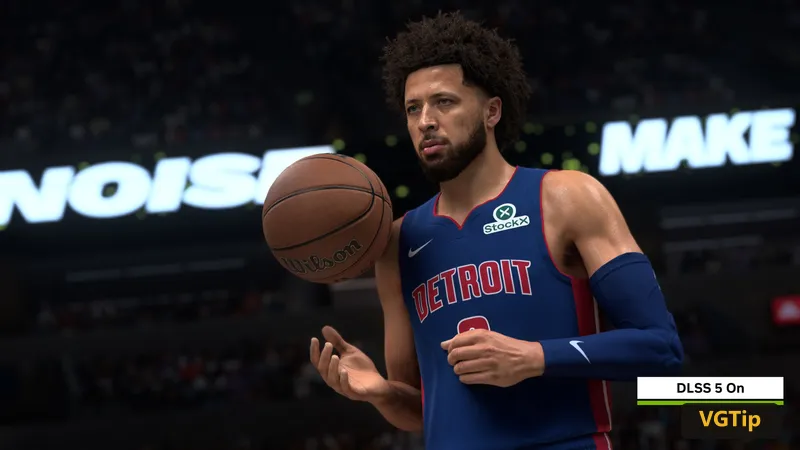
图 20–21|《NBA 2K27》厂商对比。
这里可以直接比较面部与右肩的高光,开启后亮点的分布和局部阴影发生变化,手背肌腱附近的明暗也更突出。球衣上的褶皱阴影随之改变,人物大体轮廓仍对应同一镜头。
PC Gamer 在 2026 年 9 月 4 日测试早期版本,配置为 RTX 5080、Ryzen 7 9800X3D、32 GB 内存,4K Ultra、RT 开启、SR/FG 关闭。启用 DLSS 5 前后的平均帧率为 183 与 49 FPS,换算成平均帧间隔约为 5.46 与 20.41 ms,差约 14.94 ms。
面对这组结果,最有用的问题依然是时间换来了什么?玩家可以把外观变化与更高输入、更多光照采样、更快源帧放在相近预算下比较,也可以观察实际比赛镜头里这些变化有多明显。下一次进入游戏设置,改一个选项验证一次,你也许就会知道这个变化为什么有效了。
参考资料
D1|SR 质量与开销:TechSpot,2026-01-23。
D2|模型的分区域画质分析:Digital Foundry,2026-01-23。
D3|RR 模型比较:TechSpot,2026-08-26。
D4|MFG 呈现与 PC latency:TechSpot,2025-01-28。
D5|显示端帧节奏:TechSpot,2025-12-10。
D6|早期外观生成测试:PC Gamer,2026-09-04。
D7|源帧、生成帧与 UI 伪影:GamersNexus,原测试 2025-02-20。
D8|RR 的细节与动态恢复:TechSpot,2025-02-08。
理论与实现:PBRT 第四版、DXR、Unreal TSR、FSR SDK、DLSS 开发者资料。