本文正文約 9200 字,預計閱讀 35 分鐘。
開啟遊戲,你把超解析度設為 Quality,光追開啟,幀生成設成 4×,遊戲幀率便從幾十漲到了兩百多,轉動視角也順滑了不少。但玩上一會兒,還是能覺出一些不對勁:瞄準時滑鼠沒那麼跟手,過彎時路邊的護欄偶爾會扭一下,走進暗處,剛出現在視野裡的反射要等一會兒才穩定下來。
這篇文章將圍繞三個問題展開:同樣顯示 240 FPS,為什麼手感差很多?輸入畫素降到四分之一,為何效能只提高一部分?光追的噪點已經消失,為什麼反射仍會拖影?一起來吧,逐步拼出 SR、RT/PT、光線重建、FG/MFG 與低延遲排程這幅全景。
一、同樣 240 FPS,一臺跟手,一臺遲緩?
先做一個理想化對照。甲配置每秒渲染 240 張完整場景,乙配置每秒渲染 60 張,再用 4× 幀生成補出其餘畫面。假設輸出足夠均勻,兩者都能每隔約 4.17 ms 向顯示系統交付一張圖。沿著道路移動時,乙也能提供密集的運動位置;當你突然改變方向時,甲每隔約 4.17 ms 就有一次新的場景渲染機會,乙的完整場景間隔則約為 16.67 ms。
這裡我們把經過完整場景渲染的畫面叫作源幀,把送往顯示系統的序列叫作呈現幀。源幀可以經過超分、去噪和後處理,生成畫面則估計源幀之間的時刻。遊戲模擬與輸入取樣可以採用各自的頻率;源幀間隔描述的是新場景經過渲染交付的節奏。這樣一來,都是240 FPS,我們就要再問一句:源幀有多少,生成畫面有多少?
把 FPS 換成毫秒,差異會更直觀。60 FPS 對應約 16.67 ms,120 FPS 對應 8.33 ms,240 FPS 對應 4.17 ms。下面公式裡的 T_frame 為平均幀間隔,單位為毫秒。後面所有開銷都用這筆賬來算:每多花 2 ms,你希望換來多少細節、多少光照,或者多少中間畫面?
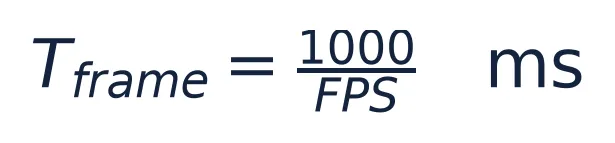
TechSpot 在 2025 年 1 月 28 日測試《心靈殺手 2》,使用 RTX 5090、4K 輸出、DLSS Quality,並始終開啟 Reflex,得到下面這組結果。呈現 FPS 與 PC latency 沿用評測資料,源幀率由呈現 FPS 除以倍率估算。
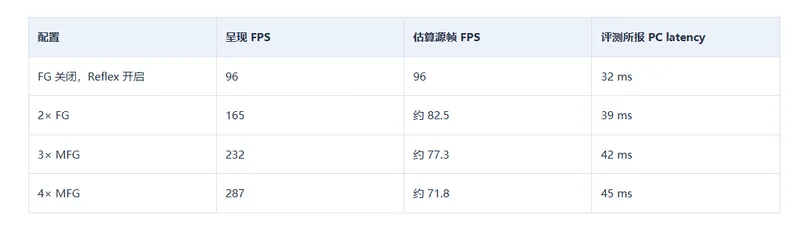
先看最後一行:螢幕得到的畫面從 96 張增加到 287 張,源幀的生產速度則降到了約 71.8 FPS,對應約 13.9 ms 一張。生成階段加入的工作改變了源幀預算,評測報告的 PC latency 也從 32 ms 增至 45 ms。在這套配置下,提高倍率確實增加了呈現密度,同時付出了源幀速度和 PC 內部延遲的代價。
滑鼠移動之後,遊戲需要把這次輸入納入狀態更新,並將對應的渲染工作交給 GPU。若工作在佇列裡等了很久,即使執行本身很快,最終顯示的仍是較早處理的狀態。Reflex、Anti-Lag 和 XeLL 主要著手減少這段等待,讓輸入處理更靠近實際執行。下面的公式將沿途延遲加在一起。
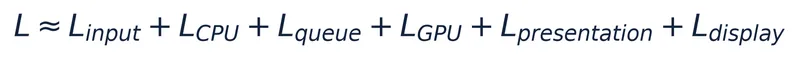
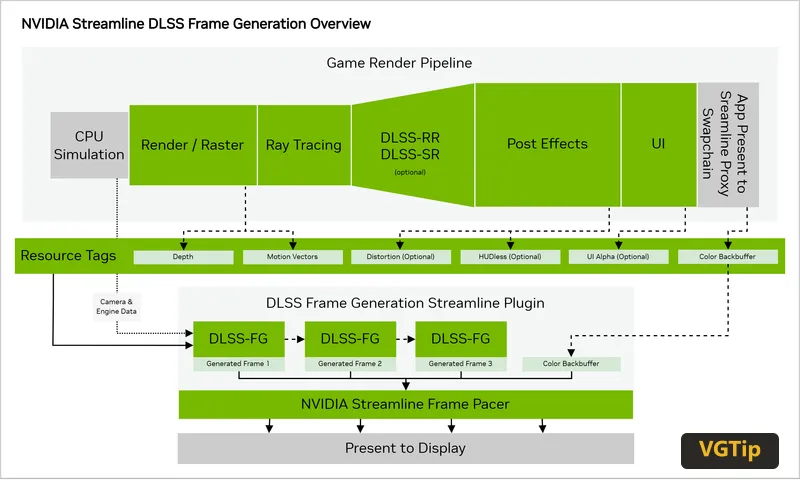
再看下面的整合圖,可以先沿著顏色結果從渲染走到呈現。光線重建與超分會改變交給幀生成的影象,因此前級留下的模糊或錯誤也會進入生成輸入。再看深度和運動向量的支路,同一份資源被多個階段使用,上游的描述誤差就可能影響幾處結果。圖中的連線關係解釋了一個重要現象:某個問題雖然在開啟 FG 後更顯眼,排查時仍可能需要回到 SR、光照或運動輸入。
回到甲、乙兩套 240 FPS 配置。判斷它們時,可以先看完整場景多久交付一次,再看中間畫面是否均勻、正確。接下來,我們先讓完整場景更快地產生:把輸入畫素壓到四分之一,看看能省下多少時間。
二、畫素只剩四分之一,幀率卻沒翻四倍?
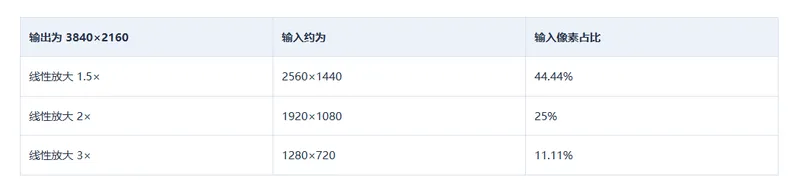
我們知道,4K 輸出為 3840×2160,約 829 萬畫素;1080p 輸入為 1920×1080,約 207 萬畫素。寬高各減半,畫素數量就剩四分之一。若一幀裡的所有工作都隨輸入畫素同比縮減,效能確實可以接近四倍。但實際渲染還要處理幾何、場景結構和部分後處理,超分本身也要組織完整的 4K 輸出。我們從一個可手算的 GPU 預算開始。
假設原生渲染花 17 ms:其中 5 ms 屬於這裡暫按固定處理的工作,12 ms 隨輸入畫素縮放。輸入畫素改為四分之一,這 12 ms 變成 3 ms,再支付 2 ms 的重建開銷,合計就是 10 ms。源幀從約 58.8 FPS 提高到 100 FPS。最關鍵的是淨省下的 7 ms:畫素相關工作省了 9 ms,重建花掉 2 ms。
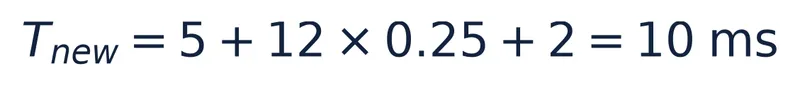
這 7 ms 可以直接換成更快的源幀,也可以部分投入光追。比如再花 4 ms 改善光照,總 GPU 時間就從 10 ms 回到 14 ms,約為 71.4 FPS;與原先的 17 ms 相比,保留了 3 ms 的速度收益。反過來,若某場景原本只有 2 ms 畫素相關工作,另有 5 ms 固定開銷,同樣操作後就是 5+0.5+2=7.5 ms,高於原先的 7 ms。
再把 CPU 加回來。假設 CPU 每幀需要 12 ms,GPU 已經從 17 ms 降到 10 ms,連續產出就會主要受 CPU 節奏約束,源幀大致接近 83.3 FPS。此時進一步降低輸入解析度,GPU 的空餘可能繼續增加,源幀提升則逐漸趨緩。
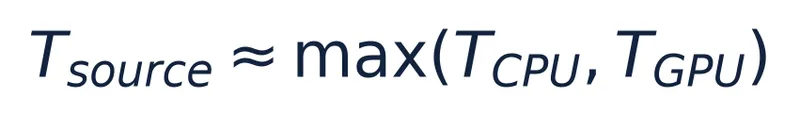
實際 GPU 階段還可能重疊執行。重建與其他工作並行時,最終新增多少幀時,要看它延後了哪一項關鍵工作。選擇超分檔位時,可以先按下表把輸入規模算清楚:1.5×、2×、3× 指寬高上的線性放大,畫素佔比隨寬高一起變化。
計算效能差距之後,另一個疑問才真正出現:只採了四分之一的畫素,細節從哪裡來?先讓相機停住,盯著遠處一根很細的電線。如果每幀都在相同位置取樣,錯過的細線就可能一直被錯過。Jitter(抖動) 會輕微改變下一幀的亞畫素取樣位置,讓原先空缺的觀察有機會被補上。只要這些結果確實屬於同一根電線,重建器就能把多次觀察積累起來,逐漸建立穩定的細輪廓。
相機開始移動後,積累過程多了一道對齊任務:電線在螢幕上的位置變了,上一幀的顏色應當搬到哪裡?運動向量為重投影提供這個對應關係,歷史透過校驗後才參與當前重建。
現在讓人物從電線前面跑過。人物離開後,背景突然露出;此前該位置儲存的顏色屬於人物,當前需要恢復背景。重建器需要依靠深度、運動、亮度變化等線索拒絕這段歷史,並用當前稀疏觀察重新開始。你看到的輪廓殘留、突然閃動和逐漸穩定,就對應這次判斷與重新積累的過程。
下面用簡化混合式描述它。Hₜ(x) 為當前重建結果,Cₜ↑(x) 為當前低解析度觀察的重建,Hₜ₋₁ 為歷史;𝒲 根據運動資訊 vₜ 重投影,wₜ(x) 決定歷史貢獻。歷史權重較大,靜態細線更容易穩定,過時顏色也會保留更久;更積極地採用當前觀察,新露出區域跟進更快,取樣不足處會更容易閃動。
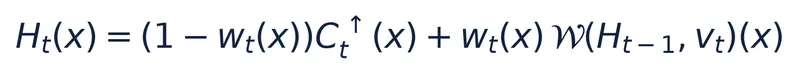
把觀察物件換成《地平線:西之絕境》的瀑布,水流內部一直在變化,半透明水霧疊在巖壁前面,用一組表面運動去解釋整個畫素會很吃力。下面是 AMD 釋出的同場景對照,上圖採用 FSR 3.1,下圖採用 ML FSR Upscaling。
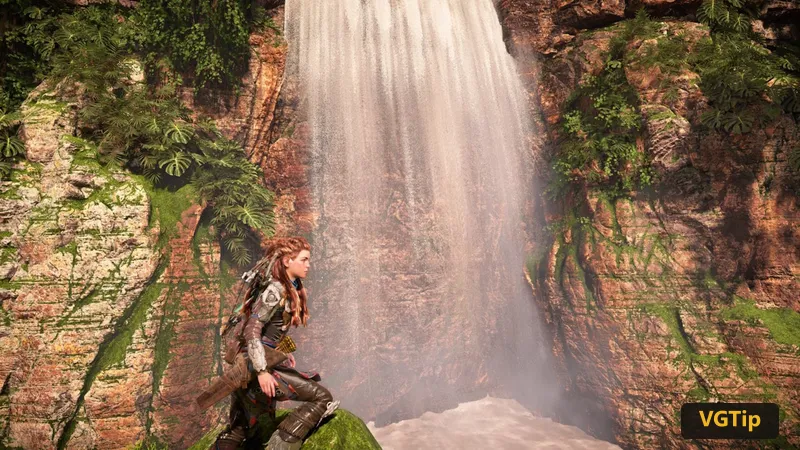
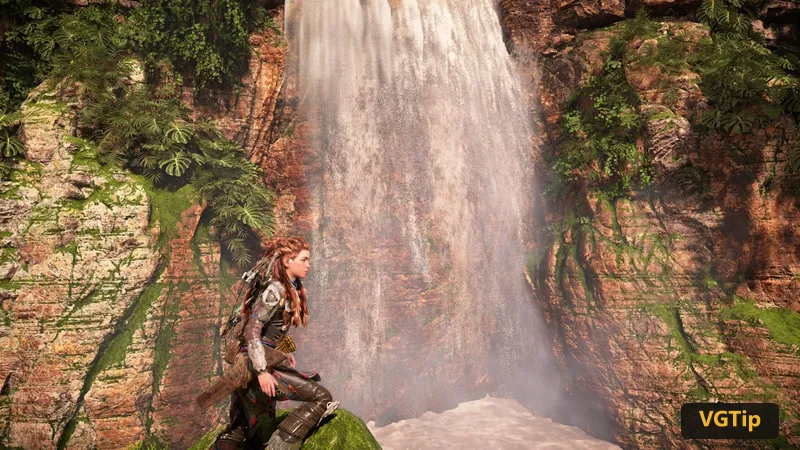
圖 3–4|AMD 原圖。對照瀑布中上部的水流結構,人物與兩側巖壁可作為位置參照。
上圖的瀑布呈現較均勻的豎向條紋,中段的水霧像一層稀薄白紗;下圖能看見更明顯的水流分叉和寬窄變化,亮水束之間也保留了暗縫。兩側巖壁與人物的大輪廓相近,主要差異集中在持續變化的水流內部。
玻璃和鏡面反射也有類似困難。一層玻璃可能同時承載前景和透射背景,單個運動向量對這種混合關係的表達有限。引擎提供的遮罩可以提示演算法對相應區域加快更新;輸入訊號的組織方式因此會影響同一演算法在不同遊戲裡的效果。
TechSpot 在 2026 年 1 月 23 日用《賽博朋克 2077》4K Ultra RT、Quality 檔比較 DLSS 4.0 Preset K 與 4.5 Preset M:RTX 5070 Ti 的幀率約下降 5%,RTX 3090 約下降 19%。換成單幀時間,分別約增加 5.3% 和 23.5%。
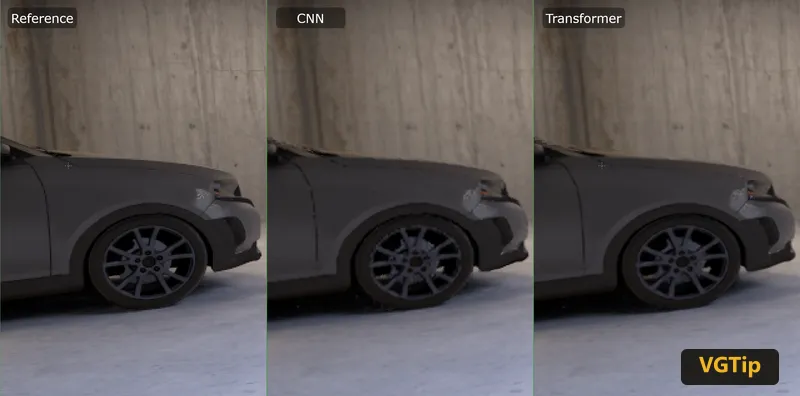
圖 5|NVIDIA 研究頁原圖。
這張圖可以看車前輪的細輻條:中間結果的斜線邊緣呈現更明顯的斷續和鋸齒,右側的輪廓更連貫,形態也更接近左側參考。
回到原先的 17 ms 場景。超分幫我們淨省了 7 ms,但畫質還依賴歷史。現在把一部分時間交給光追:它會為畫素收集另一類資訊——光從哪裡來,經過哪些表面,怎樣才能讓反射、陰影和間接光照更貼合場景。
三、光追已經去掉噪點,為什麼反射仍會拖影?
走進《賽博朋克 2077》的室內,先看一塊映著身後物體的玻璃。要算出這塊玻璃的顏色,渲染器需要知道反射方向會碰到什麼;那個物體即使落在視野外,仍然會影響當前畫素。光線追蹤為這種查詢提供了場景資訊。路徑追蹤把查詢繼續沿散射路徑展開,估計光經過其他表面後送來的貢獻,因此也能將間接光照納入同一套光傳輸計算。
下面的渲染方程展示,一個表面向眼睛送出的光,來自自發光和各個入射方向的反射貢獻。Lₒ 為出射輻射亮度,Lₑ 為自發光,Lᵢ 為入射光,fᵣ 描述材質怎樣分配反射,餘弦項計入方向與表面法線的關係。積分表達的是整個反射半球。我們只需抓住一件事:為了知道這個畫素有多亮,渲染器需要了解其他方向送來了多少光。
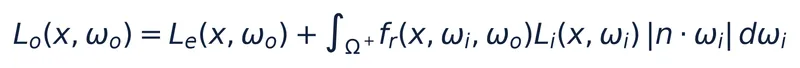
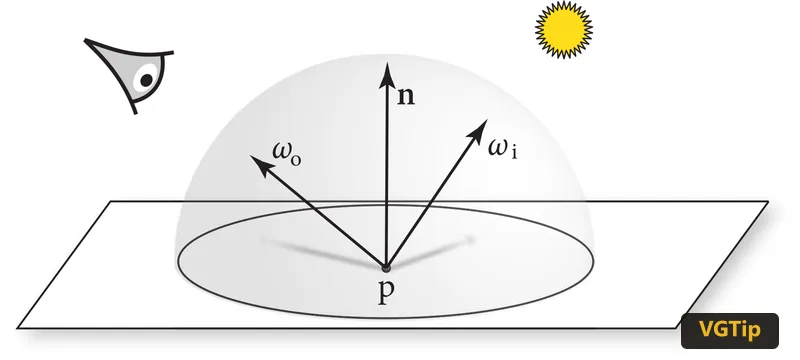
圖 6|圖中的入射方向對應需要估計的光,出射方向對應觀察方向。
遊戲每幀只有幾毫秒可用,渲染器會取樣部分方向,用有限路徑估計整個積分。若某個方向恰好碰到強光,貢獻很大;另一個方向落在暗處,貢獻很小。少量隨機觀察就會形成亮暗起伏,也就是噪聲。下面的蒙特卡洛估計用 N 個樣本及其機率密度 p(xᵢ) 來計算結果。在常見的獨立取樣條件下,標準誤差按樣本數平方根下降:想讓噪聲幅度減半,通常需要約四倍樣本。
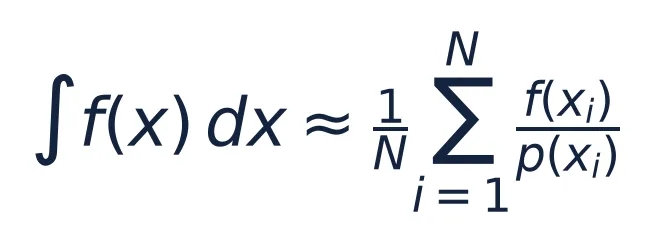
這可以與前面的超分預算接起來。假設增加光追取樣能佔用的額外時間只有 4 ms,直接把所有樣本翻四倍,很容易超過預算。首先可以改善查詢的去向:同樣發出一條射線,找到重要光照貢獻比落在幾乎全黑的方向更有價值。取樣策略由此成為提升效率的入口。
例如,房間裡的主要照明來自一盞很小的強光。純粹隨機挑方向,可能花了不少查詢仍錯過它;直接取樣光源,就能更有針對性地估計這部分貢獻。如果鄰近畫素或上一幀已經找到有價值的光源候選,ReSTIR 還可以透過時空重取樣複用它們。
間接光的重複查詢則引出另一種辦法。假設很多路徑都會繼續詢問某一區域能送來多少反彈光,把這個估計儲存到輻射快取,就能減少後續重複計算。快取的估計需要隨場景變化更新;燈光突然移動時,舊值退出得有多快就會影響動態表現。這裡已經出現了與時域超分類似的取捨:複用帶來效率,同時需要及時識別過時資訊。
射線查詢本身也有開銷。為了快速找到可能命中的物體,BVH 用層次包圍區域排除大片空間,查詢只在有希望命中的區域繼續深入。物件內部的結構通常放在 BLAS,例項及其變換由 TLAS 組織。場景中的人物開始蒙皮變形後,相關結構也需要更新,所以減少發射射線的畫素,仍會留下場景組織這筆開銷。
先把效能問題留在這條查詢鏈上,再來看重建本身會怎樣改變畫面。下面《心靈殺手 2》金屬門的 CNN 與 Transformer RR 對照,觀察物件是同一塊粗糙反射表面的細節。
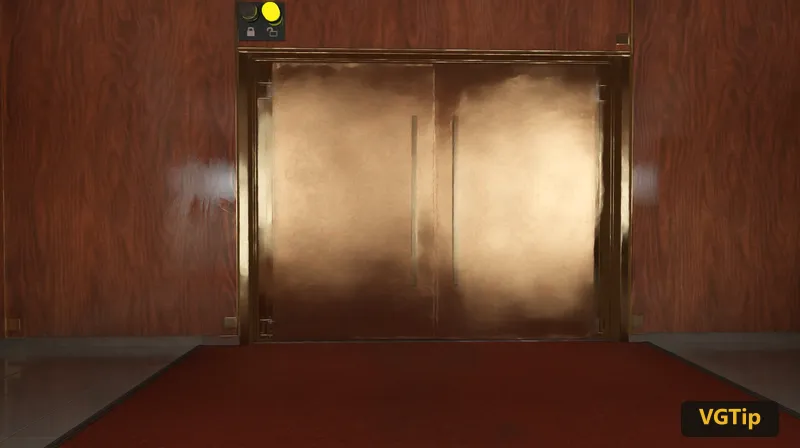
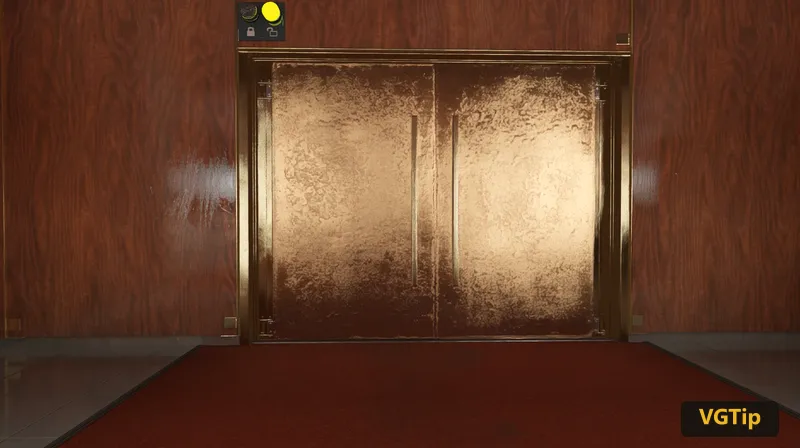
圖 7–8|NVIDIA 釋出的同場景模型對照。
上圖的金屬門仍有完整的亮暗輪廓,但高光覆蓋的門板被處理成較平滑的色塊;下圖在相同位置出現了密集的斑駁結構,中央兩根門把手附近也更容易辨認區域性變化。兩張圖都能給出乾淨的門,高頻細節的處理明顯不同。
TechSpot 在 2025 年 2 月 8 日的 RR 分析中,保持 SR 模型一致,比較舊 CNN 與新 Transformer RR。它報告新模型改善了多種表面的紋理和運動穩定性,同時觀察到停住後一兩秒細節逐步收斂,光照改變仍需數幀響應。
再看《賽博朋克 2077》的含噪輸入與重建結果,上面的問題會變得更直觀。
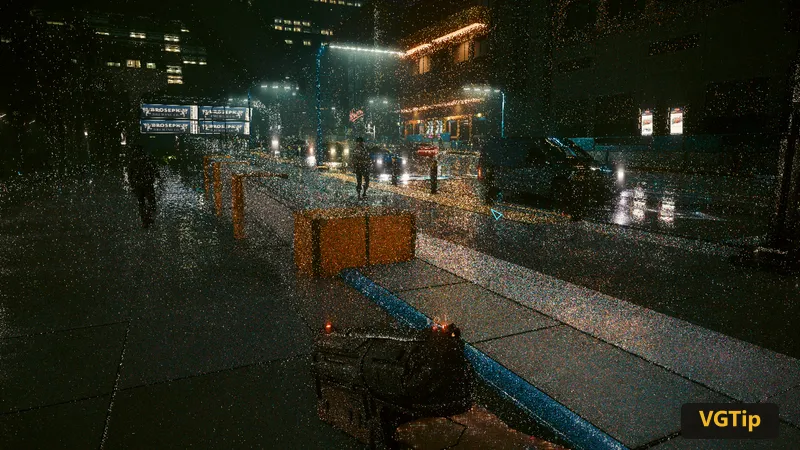
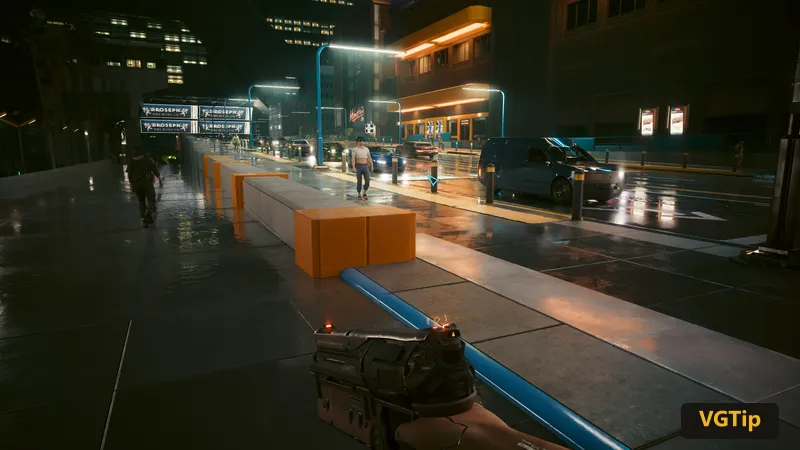
圖 9–10|NVIDIA 釋出的含噪輸入與重建結果。
輸入中,橙色路障的表面散佈著強烈的亮暗顆粒,右側路面反射也被噪點切碎;重建後,路障恢復為連續色面,車燈下的反射呈現出明確的亮帶。這組變化展示了稀疏光照經過整理後如何形成可閱讀的表面。
於是,本章的問題還剩時間這一半。反射拖影的常見原因包括舊歷史退出緩慢、重投影對應有誤,以及相關快取更新滯後。相機停住時,歷史積累容易壓低噪聲;突然轉向後,新露出區域只有少量當前樣本,演算法就要重新取捨。若繼續倚重舊歷史,過時光照會跟著留下;若更快交給當前觀察,取樣稀疏處又可能閃動。驗證這一點,可以讓遮擋物移開,記錄反射從露出到穩定的過程,上面的靜態圖承擔的是展示噪聲與細節兩類結果。
RR 與 SR 的處理順序也會影響資訊保留。若低解析度去噪先抹掉了細小反射,後續超分接到的就已經是平滑訊號。聯合重建嘗試讓幾個任務共享更多原始資訊,DLSS RR 採用這條路線;AMD Ray Regeneration 則提供獨立去噪的介面路徑,便於分別組織各階段。下面兩張圖把這個差別畫在了訊號經過的位置上。
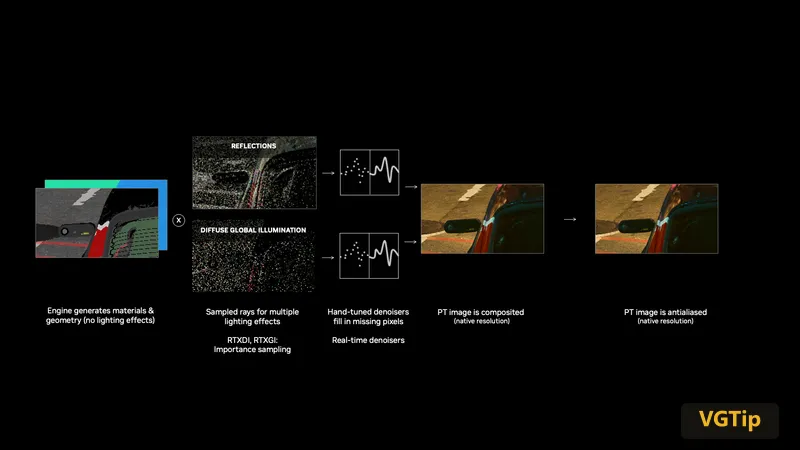
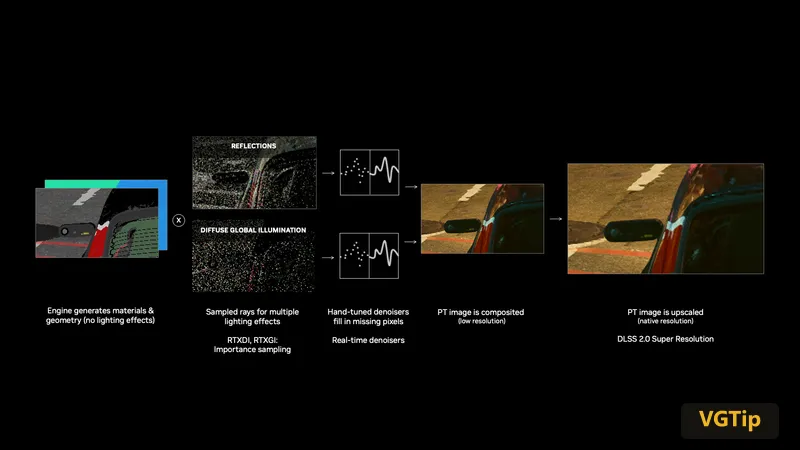
圖 11–12|分立流程與聯合重建示意。
成本如何?TechSpot 在 2026 年 8 月 26 日比較 RR Preset D 與 F,五款測試遊戲的大多數結果相差約 1 FPS 以內,並觀察到部分噪聲與細節變化。把它與第二章的 SR 測量放在一起,就能理解:同一代產品名稱下,SR 與 RR 的模型更新可以帶來不同的開銷變化。
如果想判斷這筆光照預算換來了什麼,《黑神話:悟空》的水池更適合直接對照。
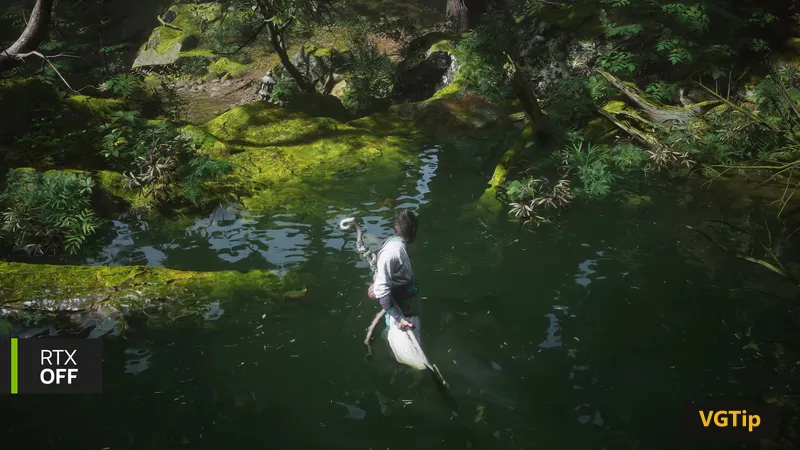
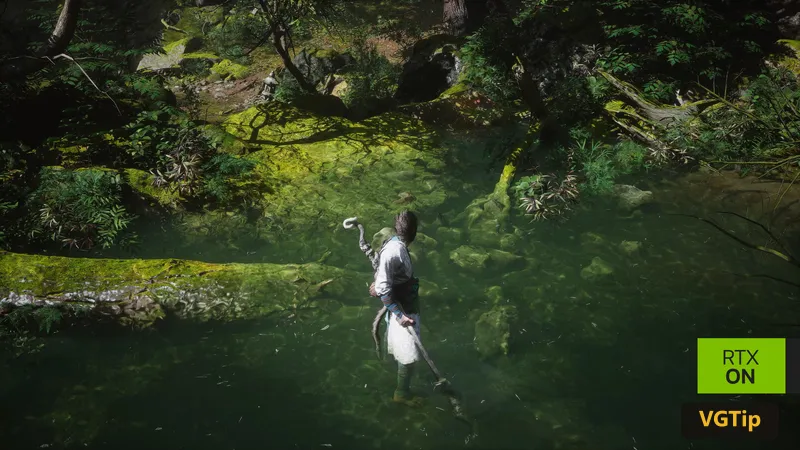
圖 13–14|同場景開關對照,來自 NVIDIA。
關閉時,池面有明顯的大片淺藍反射,池底的亮暗較平緩;開啟後,淺水區域能辨認出更密的石塊形狀和隨水面折射扭曲的亮紋。這些亮紋對應光經起伏水面折射後在池底重新分佈的焦散。比較的意義因此落在可指認的光照關係上:新增計算讓水下受光具有更豐富的空間結構。該開關同時改變反射等效果,圖中整片水面的差異包含多項光照變化。
到這裡,一張源幀已經經過稀疏光照、歷史重建與超分。它可能很乾淨,也可能留著反射拖影或邊緣遊動。接下來,幀生成會把這些結果當作輸入,估計更多中間時刻。於是第三個問題接上了第一個:我們希望把畫面補得更密,同時保證補進去的內容更值得顯示。
四、補出來的畫面,在護欄和 HUD 上露餡?
想象《F1 25》裡一次持續過彎:車身向一側移動,近處護欄迅速掠過,遠處建築移動較慢,HUD 固定在螢幕上。如果只把前後兩張源幀疊起來,車會出現重影,背景也會錯位。FG 需要先建立對應關係,再估計中間時刻各個位置應當出現什麼。下面公式中,Iₜ 和 Iₜ₊₁ 為相鄰輸入,α 為相對時間,v 與 d 提供運動和深度,F 表示生成過程。
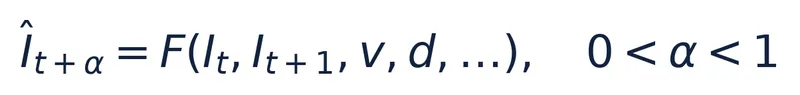
車身移開後,原先擋住的背景只在部分輸入中出現。此時即使已經知道車身怎樣運動,仍要判斷空出來的位置應當由誰補上。反射和陰影也會帶來獨立於表面幾何的變化,光流從顏色影象中估計表觀運動,幫助演算法建立這些對應。遮擋頻繁變化的細護欄因此很有價值:它反覆要求演算法在前景與背景之間切換可見關係,很容易暴露估計誤差。
源幀間隔越長,估計跨度越大。30 FPS 的相鄰源幀相隔約 33.33 ms,60 FPS 相隔約 16.67 ms;相同速度下,前者跨過的位移更大,期間顯露和遮住的背景也更多。提高倍率是在這段跨度內增加估計時刻。因此,提升源幀速度常常能同時改善互動和生成條件。
多幀生成會複用一部分輸入特徵,再為多箇中間時刻進行處理。4× 對應每個源幀週期四張呈現畫面,其中三張為生成畫面;6× 對應五張生成畫面。模型計算、緩衝與呈現安排共同決定實際成本。下圖展示了共享計算與各時刻處理的關係。計算輸出時,應當用開啟生成後的源幀率乘倍率:若原先 60 FPS,開啟後源幀降到 54 FPS,4× 輸出約為 216 FPS。
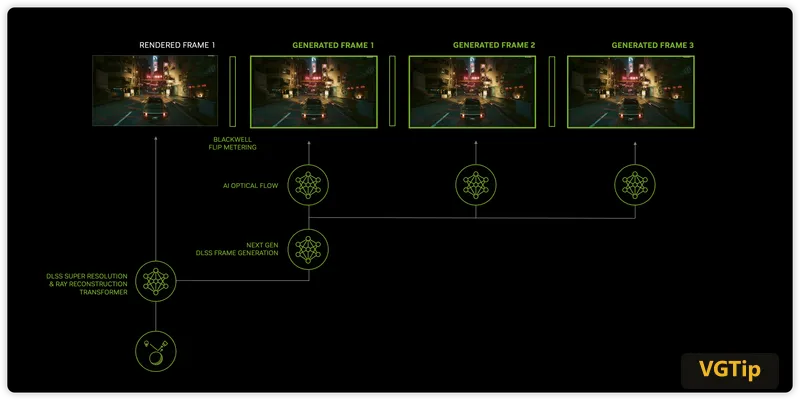
圖 15|NVIDIA 多幀生成模型示意。
HUD 提供了另一類線索。速度表固定在螢幕座標,背後的場景持續運動,二者在同一位置疊加。整合時可以把 UI 與場景分離,再單獨合成,這能給演算法更明確的層次關係。至於數字什麼時候變化,還取決於 UI 狀態的更新頻率:一張清楚的 UI 紋理若按源幀更新,其中的動畫也會沿這個節奏前進。
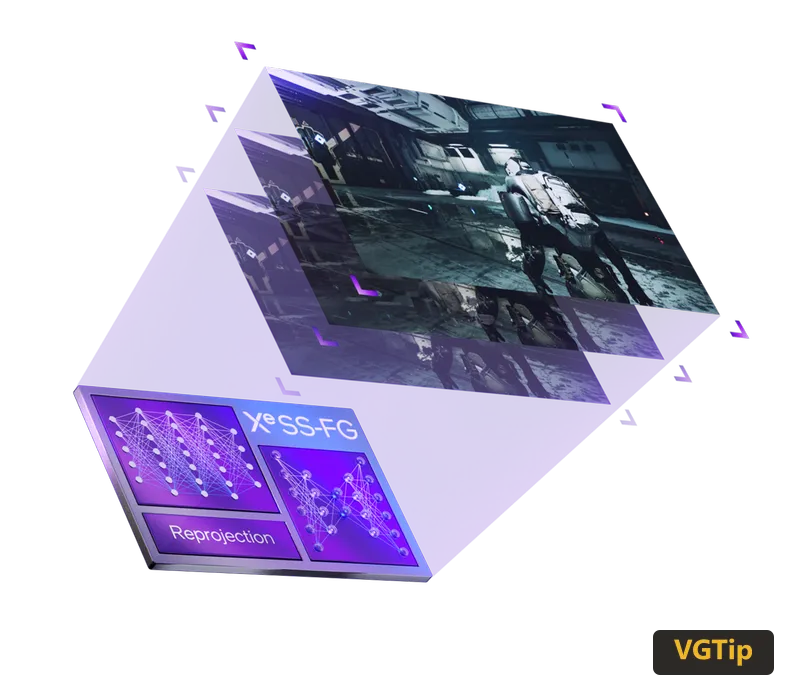
圖 16|XeSS 重投影層示意。
具體會錯成什麼樣,可以看 GamersNexus 對《最終幻想 XVI》的逐幀檢查。左邊為第一張源幀,右邊為序列中間的生成幀。該組採用約 30 FPS 源幀與 4× MFG,屬於較大運動跨度的觀察條件。
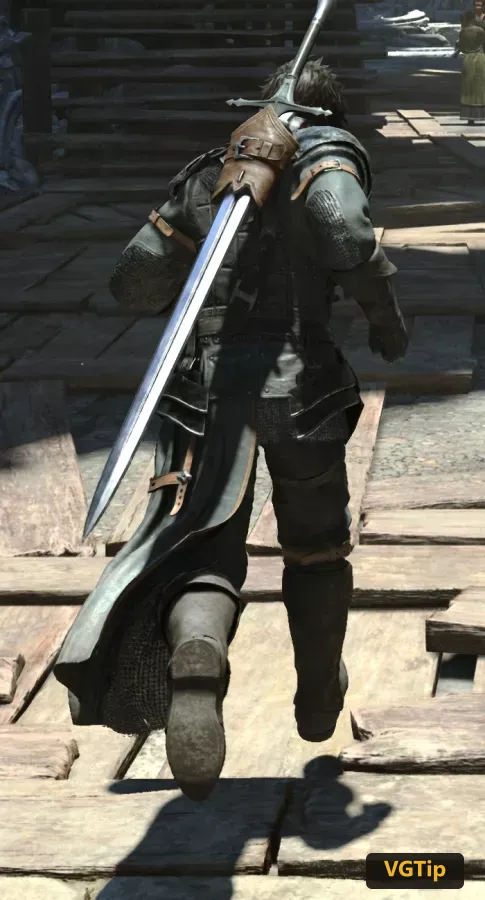
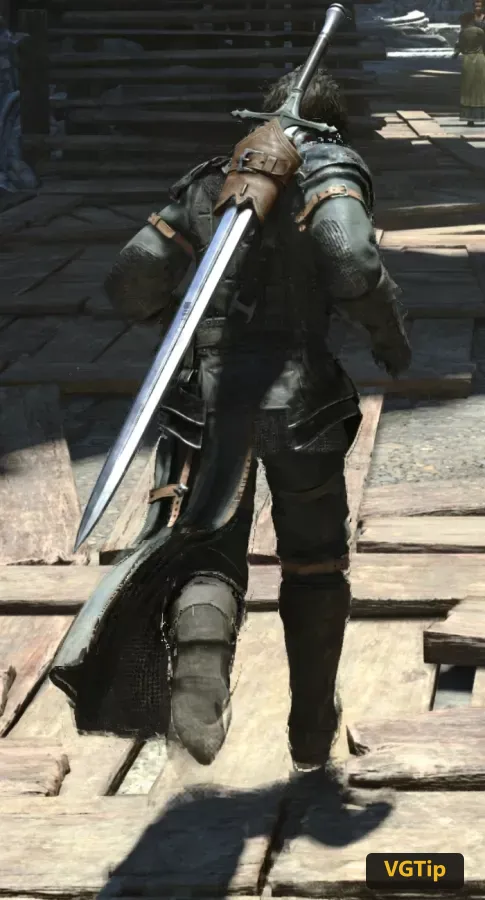
圖 17–18|GamersNexus 已釋出的裁切圖。
源幀的靴底輪廓清楚,衣襬與腿之間有明確空隙;中間生成幀的腳部出現半透明疊影,衣襬邊緣與後方木板交錯。這正是不同運動區域在中間時刻發生混合的可見結果。
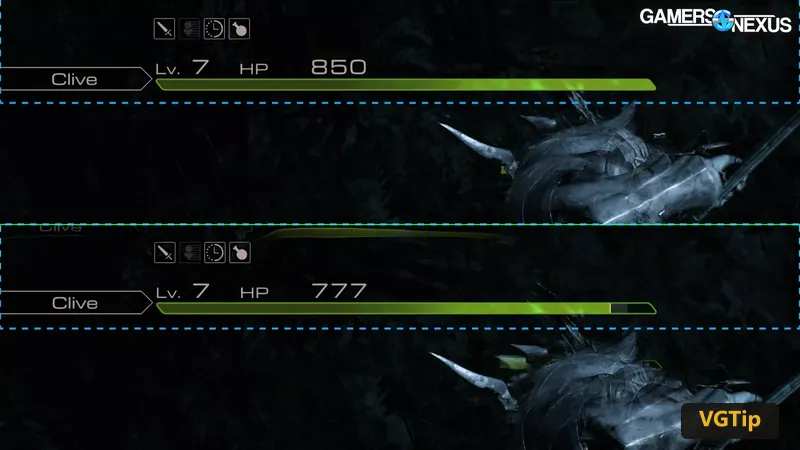
圖 19|同一評測釋出的 UI 區域性圖。
再看血條:畫面中部的主血條仍在原位,上方又出現了一段彎曲的綠色副本。它展示了場景運動與固定介面疊加時的生成錯誤,讓 UI 分離與合成的意義變得具體。
平均 200 FPS 意味著平均間隔 5 ms;若顯示間隔在 2 ms 和 8 ms 之間交替,平均值同樣是 5 ms,運動的時間分佈就會呈現明顯起伏。高倍率帶來了更多待呈現畫面,交換鏈、同步方式、限幀與顯示掃描需要將它們安排均勻。
現在再回到開頭的 240 FPS。這些現象的常見原因包括源幀產出偏慢、佇列等待、上游重建錯誤、生成階段的運動估計,以及呈現間隔波動,它們可能疊加。比如,GPU 長幀會同時拖慢操作反饋和畫面交付;護欄的抖動也可能先出現在 SR,再被生成階段帶入更多畫面。可以先關閉 FG,沿同一路線檢查源幀中的問題是否仍在,再結合幀時、延遲與呈現記錄縮小範圍。
五、給你一臺電腦,怎樣把它們變成設定?
從一條你熟悉的路線開始:室外緩慢橫移,走進有反射的室內,再快速轉向,最後停住。先關閉 FG,固定輸出解析度、光照檔位與超分模式,記錄源幀時間;有合適測量工具時同時記錄延遲。這樣會得到一條能反覆對照的起點。比如目標源幀為 90 FPS,對應約 11.11 ms。
若源幀需要 17 ms,先嚐試降低輸入尺寸,觀察它是否明顯縮短。大幅縮短,說明可縮放的 GPU 工作佔了較大比例;變化很小,再檢查 CPU、幾何、結構更新和固定處理。若實際源幀降到了 10 ms,就沿橫移與轉向過程檢查細線、粒子和新露出背景。如果質量達標,這個配置已達到 90 FPS 目標,還剩約 1.11 ms 餘量;若只有 GPU 降到 10 ms、CPU 仍需 12 ms,就先處理 CPU 一側的限制。
接著決定光照預算。把同一室內的光追關閉與開啟結果對照,指出你實際獲得的變化:反射內容、間接光層次、陰影關係或水底焦散。再檢查新增成本和運動恢復。如果某項效果在主要遊玩視角里貢獻很小,而開啟後源幀明顯超預算,這筆時間可以轉給更高輸入或更短響應。
源幀質量與速度確定後,再開啟 FG 並逐級比較倍率。每次切換都重新記錄源幀時間,因為生成工作也會爭用預算。若護欄出現新的變形,回到關閉 FG 的同一路段確認它從哪一階段開始;若手感與連續性同時變差,先檢視是否出現長幀或更深的等待。第一章的《心靈殺手 2》資料已經展示,倍率提高時源幀和延遲可能一起變化。
這套順序也能用於理解新的外觀生成階段。DLSS 5 的 3D-Guided Neural Rendering 以渲染結果、運動與時間狀態等為條件,結合學習到的外觀先驗處理材質和光照外觀。《NBA 2K27》的皮膚、衣料與區域性照明是可見案例。
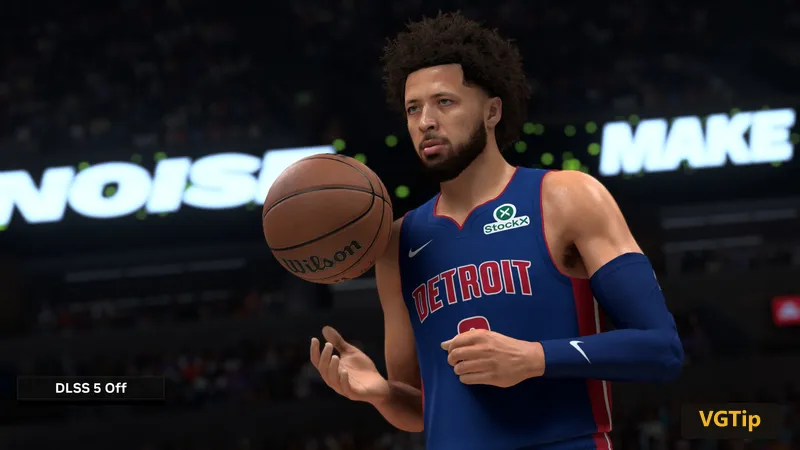
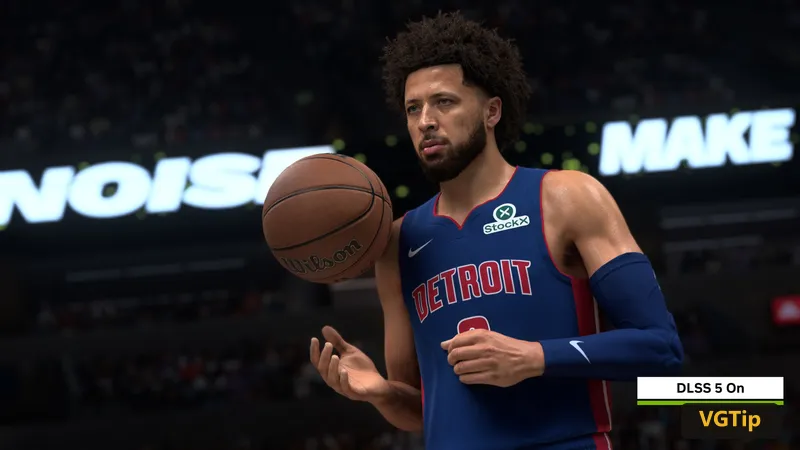
圖 20–21|《NBA 2K27》廠商對比。
這裡可以直接比較面部與右肩的高光,開啟後亮點的分佈和區域性陰影發生變化,手背肌腱附近的明暗也更突出。球衣上的褶皺陰影隨之改變,人物大體輪廓仍對應同一鏡頭。
PC Gamer 在 2026 年 9 月 4 日測試早期版本,配置為 RTX 5080、Ryzen 7 9800X3D、32 GB 記憶體,4K Ultra、RT 開啟、SR/FG 關閉。啟用 DLSS 5 前後的平均幀率為 183 與 49 FPS,換算成平均幀間隔約為 5.46 與 20.41 ms,差約 14.94 ms。
面對這組結果,最有用的問題依然是時間換來了什麼?玩家可以把外觀變化與更高輸入、更多光照取樣、更快源幀放在相近預算下比較,也可以觀察實際比賽鏡頭裡這些變化有多明顯。下一次進入遊戲設定,改一個選項驗證一次,你也許就會知道這個變化為什麼有效了。
參考資料
D1|SR 質量與開銷:TechSpot,2026-01-23。
D2|模型的分割槽域畫質分析:Digital Foundry,2026-01-23。
D3|RR 模型比較:TechSpot,2026-08-26。
D4|MFG 呈現與 PC latency:TechSpot,2025-01-28。
D5|顯示端幀節奏:TechSpot,2025-12-10。
D6|早期外觀生成測試:PC Gamer,2026-09-04。
D7|源幀、生成幀與 UI 偽影:GamersNexus,原測試 2025-02-20。
D8|RR 的細節與動態恢復:TechSpot,2025-02-08。
理論與實現:PBRT 第四版、DXR、Unreal TSR、FSR SDK、DLSS 開發者資料。